Блог пользователя machine_solution

Автор machine_solution, 7 месяцев назад, По-русски

Не закрывайте этот пост, пусть номер задачи вас не пугает. Уверяю, что реализация этой задачи сопоставима с реализацией задачи B из Div 2 раунда.

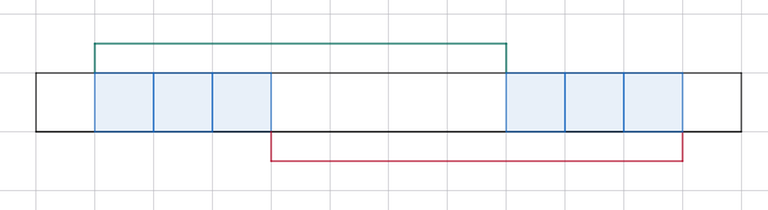
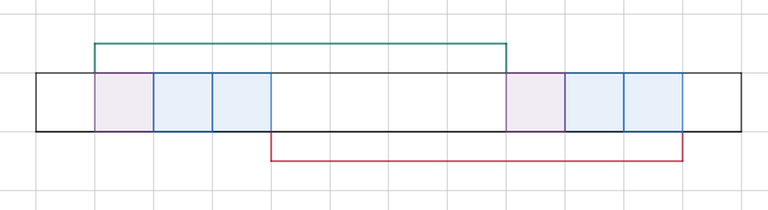
Этот пост посвящён задаче G. Рациональная пузырьковая сортировка из Div 1 + Div 2 раунда, которая является примером, что математический подход может решать даже такие сложные задачи по программированию. Итак, реализация тут простая, но как же додуматься до решения? Этому и посвящён текущий пост

Задача такова — дано $$$n \leq 10^6$$$ целых неотрицательных чисел, за один ход мы можем усреднить два соседних числа, получая уже рациональные числа. Требуется понять, можно ли за 0 или больше таких операций сделать массив неубывающим.

Итак, у нас есть задача, ответом на которую является "Да" или "Нет", так что логично будет попытаться найти какие-то случаи входных данных, в которых ответ нас будет известен. Так как в задаче есть много вариантов действий, давайте сначала попробуем понять, когда ответ точно "Да"

Вопрос 1: Опишите какие-нибудь ограничения на входные данные, при которых ответ всегда "Да"

Подсказка 1.1
Ответ 1.1
Подсказка 1.2
Ответ 1.2
Подсказка 1.3
Ответ 1.3
Подсказка 1.4
Ответ 1.4

Итак, мы поняли один, но довольно частый и реалистичный случай, в котором ответ "Да". Следует закономерный вопрос

Вопрос 2: Нет ли ещё случаев, когда ответ точно "Да"?

Подсказка 2.1
Ответ 2.1
Подсказка 2.2
Ответ 2.2

Итак, мы уже получили сильное свойство, довольно частое, при котором ответ всегда "Да"

Вопрос 3: Достаточно ли его?

Ответ 3

Давайте попробуем понять, когда же из оставшихся случаев ответ "Нет"

Вопрос 4: Когда ответ точно "Нет"?

Подсказка 4.1
Ответ 4.1
Подсказка 4.2
Ответ 4.2
Подсказка 4.3
Ответ 4.3

Мы довольно сильно переформулировали задачу и получили строгое разделение на ответы "Да" и "Нет". Нужно только понять, как проверить условие на "Нет"

Вопрос 5: Как же это проверять?

Подсказка 5.1
Ответ 5.1

Итого, наше решение работает за $$$O(n)$$$ и использует не больше реализации, чем начальная задачка на div 2 раунде, но содержит в себе математическую сложность. Пишите в комментарии, насколько просто в итоге додуматься до этой задачи? Ведь несмотря на большое количество текста, шаги в нём не самые сложные

Замечание: Если Вам понравился это пост, то, возможно, Вам понравится контент из телеграм канала, в который я выкладываю свою подготовку к финалу ICPC 2026. Переходите по ссылке

Полный текст и комментарии »

  • Проголосовать: нравится
  • +1
  • Проголосовать: не нравится

Автор machine_solution, 7 месяцев назад, По-русски

Всем привет!

Сегодняшний пост посвящён задаче F с недавнего Div 1 + Div 2 раунда. Она стала локальной знаменитостью, потому что является более решаемой задачей, чем задача Е того же раунда. А сегодня мы разберёмся, почему же эта задача такая простая

Итак, переходим к задаче. В ней для каждого отсортированного массива $$$a$$$ с элементами от $$$1$$$ до $$$m$$$ нужно посчитать суммарное количество итераций, за которое стандартный бинпоиск находит в массиве каждый элемент от $$$1$$$ до $$$m$$$. В задаче эта сумма описана как $$$f(a,1,1,n)+f(a,2,1,n)+\ldots+f(a,m,1,n)$$$. Ограничение: $$$n, m \leq 10^6$$$

Давайте попробуем что-то понять про количество итераций бинпоиска в зависимости от искомого числа $$$k$$$. Интуиция подсказывает, что на всех массивах бинпоиск будет вести себя регулярным образом, нужно это лишь формализовать. Для того, чтобы быстрее нащупать идею, давайте немного упростим задачу и будем считать, что все числа в массиве $$$a$$$ различны. Это действительно удобно, так как в таком случае у каждого элемента $$$k$$$ в массиве есть единственное вхождение, на котором остановится бинпоиск, если будет его искать.

Итак, мы сделали удобное предположение того, что все числа различные и мы знаем, что у каждого числа $$$k$$$ в массиве есть своя позиция, обозначим её за $$$pos[k]$$$. Если число $$$k$$$ не встречается в массиве $$$a$$$, то оно не влияет на сумму, так что такие случаи можно не рассматривать.

Вопрос 1: Как же посчитать $$$f(a,k,1, n)$$$ в таком случае?

Подсказка 1.1
Ответ 1.1
Подсказка 1.2
Ответ 1.2

Итак, мы научились для одного массива считать значение $$$f(a,k,1, n)$$$ для любого $$$k$$$ и даже поняли некоторые особенности, которые позволяют свернуть сумму и посчитать её "на листочке"

Вопрос 2: Как же посчитать сумму $$$f(a,k,1, n)$$$ по всем $$$k$$$ в отсортированном массиве из различных элементов?

Подсказка 2.1
Ответ 2.1
Подсказка 2.2
Ответ 2.2

Теперь наших идей достаточно, чтобы вернуться к общему случаю

Вопрос 3: Как теперь посчитать сумму для всех массивов $$$a$$$, а не только для строго возрастающих?

Подсказка 3.1
Ответ 3.1
Подсказка 3.2
Ответ 3.2
Подсказка 3.3
Ответ 3.3

Итак, мы научились считать сумму для всех массивов, давайте оценим время работы:

Так как нам понадобятся C-шки с индексами порядка $$$n + m$$$, мы за $$$O(n + m)$$$ посчитаем все факториалы и обратные факториалы для быстрых вычислений. Я в своём решении предподсчитал факториалы до $$$2 \cdot 10^6$$$ перед всеми мультитестами. И само решение для каждой позиции считает сколько шагов нужно, чтобы бинпоиск до неё дошёл, а также количество массивов, для которых бинпоиск остановится на ней. Всё это суммарно за $$$O(n)$$$. Значит итоговое время работы $$$O(n + m)$$$

Как видите, в здааче не было большого числа идей и она не зря была так популярна на раунде. Надеюсь, вам понравился этот разбор и принёс пользу

Замечание: Если Вам понравился это пост, то, возможно, Вам понравится контент из телеграм канала, в который я выкладываю свою подготовку к финалу ICPC 2026. Переходите по ссылке

Полный текст и комментарии »

  • Проголосовать: нравится
  • +3
  • Проголосовать: не нравится

Автор machine_solution, 8 месяцев назад, По-русски

Всем привет!

Меня зовут Андрей Зайцев

В этом блоге уже выходило несколько разборов задач и мне кажется, что пора сделать интро

Так получилось, что в школе я занимался олимпиадной математикой и становился призёром ВсОШ, поэтому мой подход к задачам по спортивному программированию несколько отличается от традиционного и общепринятого. Я, может быть, не знаю очень сложных алгоритмов, плохо умею загонять задачи и у меня неидеальная техника. Зато я могу придумывать идейные решения, хорошо разбираюсь в математических конструкциях и стандартных алгоритмах

Первый раз до отметки 2300 я дошёл на global раундах, решая по 5-6 задач, потому что там как раз было время подумать и сделать разницу на том, что я могу решать сложные задачи, а не пытаться сдать те же 4 задачи, только с меньшим штрафом

В общем, моё преимущество перед остальными участниками схожего рейтинга — это, в первую очередь, идейность и умение думать над задачами. Поэтому иногда, после написания какого-то раунда я также пишу разбор понравившейся мне задачки в стиле "как до неё додуматься". Это не классический разбор, целью которого — рассказать решение. Мне хочется, чтобы читатель понял, какой ход мыслей позоволяет до него додуматься, а ещё лучше — прочитав несколько подсказок сам придумал решение. Тут не будет странных определений, необоснованных "заметим, что..." и конструкций из воздуха

Я сам в школе тренировался думать над задачами и теперь мне интересно поделиться приложением этой техники в спортивном программировании

Но, помимо всего прочего, я ещё и финалист ICPC 2026 и до финала я постараюсь прокачать и свои слабые стороны, подтянуть технику, алгоритмы и, конечно, сделать сильные стороны ещё более сильными. Если тебе интересен процесс моей подготовки к финалу и/или ты хочешь первым узнавать о новых постах в этом блоге — добро пожаловать в телеграм канал

Полный текст и комментарии »

  • Проголосовать: нравится
  • +9
  • Проголосовать: не нравится

Автор machine_solution, 8 месяцев назад, По-русски

Сегодняшний пост посвящён задаче D из прошедшего Codeforces Round 1082 (Div. 1). Условие задачи не самое интуитивное, я не буду его повторять и просто попрошу прочитать оригинал

В этой задаче просят считать две величины — $$$k_{max}(a)$$$ и $$$f(a)$$$, причём второе значение зависит от первого, поэтому давайте сначала попробуем разобраться, как считается $$$k_{max}(a)$$$ хотя бы для изначального массива. То есть, перефразируя часть условия, которое относится к интересующему нас значению, нам нужно посчитать наибольшее такое $$$k$$$, что в массиве существуют два подотрезка, для которых мультимножества значений совпадают

Вопрос 1: как посчитать $$$k_{max}(a)$$$ для изначального массива?

Подсказка 1.1
Ответ 1.1
Подсказка 1.2
Ответ 1.2
Подсказка 1.3
Ответ 1.3

Итак, мы умеем считать $$$k_{max}(a)$$$ для изначального массива за $$$O(n)$$$, теперь нам было бы неплохо научиться считать $$$f(a)$$$.

Вопрос 2: как посчитать $$$f(a)$$$ для изначального массива?

Подсказка 2.1
Ответ 2.1
Подсказка 2.2
Ответ 2.2
Подсказка 2.3
Ответ 2.3

Чтож, теперь мы умеем решать за $$$O(n)$$$ задачу для исходного массива, но у нас есть $$$q$$$ запросов. Мы можем изменить значение элемента в любой позиции и должны пересчитать ответ. При этом, конечно же, у нас может измениться и число $$$k_{max}(a)$$$, поэтому действовать нужно умно. Но давайте сначала поймём, что меняется при пересчёте

Вопрос 3: как пересчитать $$$f(a)$$$ при изменении, если $$$k_{max}(a)$$$ остаётся прежним?

Подсказка 3.1
Ответ 3.1
Подсказка 3.2
Ответ 3.2

Мы на финишной прямой. Осталось только разобраться с тем фактом, что $$$k_{max}(a)$$$ может меняться

Вопрос 4: что делать, если $$$k_{max}(a)$$$ может меняться?

Подсказка 4.1
Ответ 4.1
Подсказка 4.2
Ответ 4.2

После ответа на вопрос 4 мы автоматически получили пересчёт $$$k_{max}(a)$$$ помимо пересчёта $$$f(a)$$$, который работает за $$$O(log(n))$$$ на запрос, то есть $$$q \cdot log(n))$$$ суммарно. Итого асимптотика решения вместе с построением Дерева Отрезков $$$O(n \cdot log(n) + q \cdot log(n))$$$

Замечание: Если Вам понравился это пост, то, возможно, Вам понравится контент из телеграм канала, в который я выкладываю свою подготовку к финалу ICPC 2026. Переходите по ссылке

Полный текст и комментарии »

  • Проголосовать: нравится
  • +10
  • Проголосовать: не нравится

Автор machine_solution, 9 месяцев назад, По-русски

Сегодняшний пост посвящен задаче E из последнего раунда Codeforces Round 1078 (Div. 2), а именно тому, как же до неё додуматься.

Предупреждение: Все индексы в этом посте написаны в привычной для кодера 0-нумерации, вместо привычной для обычного человека 1-нумерации.

Все мы знаем, как решается задача о черепашке. Пусть дана таблица $$$n \times m$$$, в каждой клетке записаны числа $$${a_i}_j$$$. Черепашка может ходить только вниз или вправо на одну клетку, то есть из клетки $$$(i, j)$$$ в клетки $$$(i + 1, j)$$$, $$$(i, j + 1)$$$. Награда черепашки при прохождении от клетки $$$(0, 0)$$$ до клетки $$$(n - 1, m - 1)$$$ определяется как сумма значений $$${a_i}_j$$$ во всех клетках, которые она посетила. Требуется найти максимальную награду, которую может получить черепашка.

Такая задача решается за $$$O(n \cdot m)$$$ и решение находит награду максимального пути от клетки $$$(0, 0)$$$ до каждой клетки $$$(i, j)$$$.

Если же Вы не знаете решение такой задачи, рекомендуется сначала его придумать или прочитать на просторах интернета.

В этой же задаче Рафаэль сначала изменяет значение ровно одной клетки на противоположное, после чего Микеланджело решает задачу о черепашке и максимизирует свою награду. Требуется посчитать какую минимальную награду может гарантировать Рафаэль. Ограничения: $$$n \cdot m \leq 10^5$$$

Вопрос 1: как решать эту задачу за любую асимптотику?

Подсказка 1.1
Ответ 1.1

К сожалению, совсем наивного решения не хватает, чтобы решение работало меньше секунды. С другой стороны, так как в таблице меняется только лишь одна клетка, мы можем надеяться на то, что ответ в задаче про черепашку поменяется не сильно

Вопрос 2: как посчитать ответ на задачу о черепашке, если изменить значение в одной клетке?

Подсказка 2.1
Ответ 2.1
Подсказка 2.2
Ответ 2.2
Подсказка 2.3
Ответ 2.3

Из прошлых пунктов мы знаем, как посчитать ответ на задачу для изменения каждой клетки. Остался лишь последний рывок:

Вопрос 3: как посчитать ответ для изменения каждой клетки за $$$O(n \cdot m)$$$ суммарно?

Подсказка 3.1
Ответ 3.1

Итого, мы за $$$O(n \cdot m)$$$ времени и памяти суммарно научились получать ответ на все $$$n \cdot m$$$ задач о черепашке, в каждой из которых изменился знак значения одной из клеток. Теперь давайте возьмём минимум из всех полученных значений — это и будет ответом на задачу.

Замечание: Если Вам понравился это пост, то, возможно, Вам понравится контент из телеграм канала, в который я выкладываю свою подготовку к финалу ICPC 2026. Переходите по ссылке

Полный текст и комментарии »

  • Проголосовать: нравится
  • +17
  • Проголосовать: не нравится

Автор machine_solution, 10 месяцев назад, По-русски

Как вы поняли, этот пост посвящён задаче F с прошедшего полуфинала ICPC CERC 2025

Эта задача не так проста, поэтому, чтобы додуматься до решения, необходимо знать две вещи:

  1. Структуру данных "Дерево отрезков"
  2. Решение задачи о нахождении наибольшей возрастающей подпоследовательности в массиве длины $$$n$$$ и элементами от $$$0$$$ до $$$N$$$ за $$$O(n \cdot log(N))$$$ времени. При желании Вы можете придумать его сами или посмотреть решение ниже
Нахождение наибольшей возрастающей подпоследовательности

Итак, теперь мы можем переходить к задаче F. Коротко повторю условия и немного их перефразирую для удобства: нам дан массив $$$a$$$ длины $$$n \leq 2 \cdot 10^5$$$ с элементами от $$$1$$$ до $$$10^6$$$. Изначально курсор стоит на индексе $$$0$$$, а также нам приходит $$$m \leq 5 \cdot 10^5$$$ запросов. За один запрос мы можем переместить курсор влево или вправо на 1, либо изменить значение массива $$$a$$$ в индексе, на который указывает курсор, на новое число $$$x$$$. После каждого запроса изменения числа нужно вывести длину наибольшей возрастающей подпоследовательности (Longest Increasing Subsequence, далее LIS) нового массива $$$a$$$

То, что за один запрос разрешено двигать курсор только на 1 позицию, наталкивает на мысль, что мы должны поддерживать какую-то информацию о префиксе перед курсором и о суффиксе, который идёт после курсора. Для удобства обозначим за $$$A$$$ префикс $$$a$$$ до элемента $$$a[cur]$$$ не включительно, а за $$$B$$$ суффикс $$$a$$$, начиная с элемента $$$a[cur + 1]$$$ включительно, где $$$cur$$$ — текущее значение курсора. То есть $$$a = A + a[cur] + B$$$

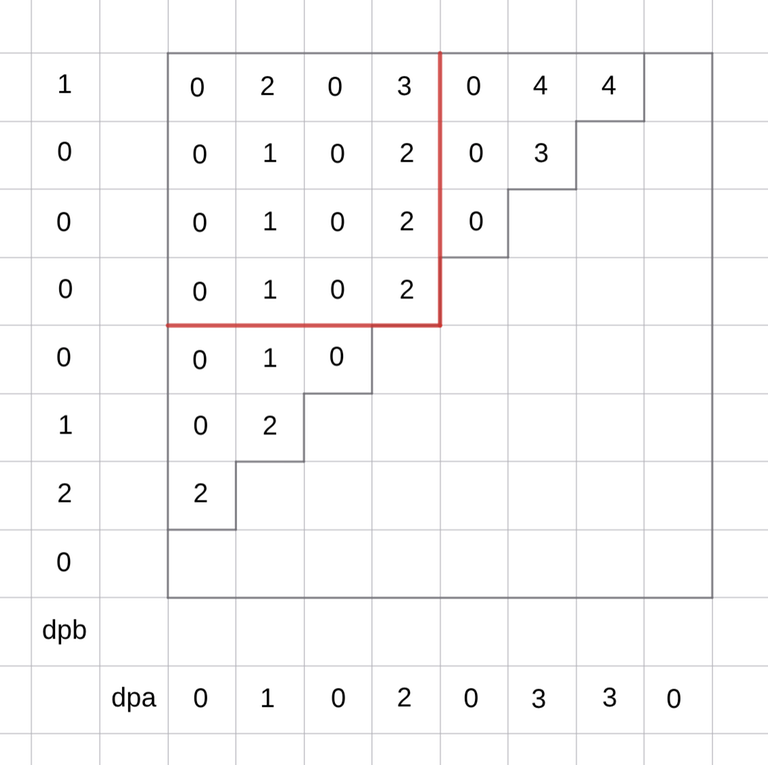
Ну раз уж мы знаем про прекрасное решение задачи о нахождении LIS, давайте хранить ровно ту же информацию в двух деревьях отрезков. Дерево отрезков для префикса будет хранить массив $$$sta$$$, где $$$sta[x]$$$ — это длина LIS в $$$A$$$, последний элемент которой равен $$$x$$$. Если таких подпоследовательностей не существует, $$$sta[x] = 0$$$. Аналогично, $$$stb$$$ — массив для суффикса, в котором $$$stb[y]$$$ — это длина LIS в $$$B$$$, первый элемент которой равен $$$y$$$

Вопрос 1: как обновлять деревья отрезков для sta и stb при перемещении курсора на 1 позицию?

Подсказка 1.1
Ответ 1.1
Подсказка 1.2
Ответ 1.2

Итак, теперь мы умеем обрабатывать запросы сдвига курсора влево и вправо. Осталось только научиться считать ответ

Вопрос 2: как посчитать длину LIS, проходящей через $$$a[cur]$$$?

Подсказка 2
Ответ 2

Теперь перейдём к более сложной части, а именно к подсчёту LIS, не проходящих через $$$a[cur]$$$

Вопрос 3: как выражается эта длина в терминах $$$sta$$$ и $$$stb$$$?

Ответ 3

Теперь, раз мы понимаем как выражается ответ, мы его можем посчитать наивным образом за $$$O(N^2)$$$

Вопрос 4: как ускорить подсчёт ответа?

Подсказка 4.1
Подсказка 4.2
Ответ 4.2
Подсказка 4.3
Ответ 4.3
Подсказка 4.4
Ответ 4.4

Мы научились считать максимум на этом треугольнике за $$$O(N)$$$, но это всё равно очень долго. С другой стороны, эта таблица практически не меняется при изменении одного элемента $$$sta$$$ или $$$stb$$$

Вопрос 5: как пересчитывать максимум на треугольнике при изменении одного элемента $$$sta$$$ или $$$stb$$$?

Подсказка 5.1
Ответ 5.1
Подсказка 5.2
Ответ 5.2

Итого, мы за $$$O(log(N))$$$ умеем считать LIS, среди всех, кто проходит через $$$a[cur]$$$ и за столько же LIS среди всех, кто не проходит через $$$a[cur]$$$. Чтобы посчитать итоговый LIS, нужно просто взять максимум из этих двух значений

Итоговая сложность решения по времени $$$O(m \cdot log(N))$$$ — хватит с запасом при данных ограничениях

Полный текст и комментарии »

  • Проголосовать: нравится
  • +37
  • Проголосовать: не нравится