


Как вы поняли, этот пост посвящён задаче F с прошедшего полуфинала ICPC CERC 2025
Эта задача не так проста, поэтому, чтобы додуматься до решения, необходимо знать две вещи:
- Структуру данных "Дерево отрезков"
- Решение задачи о нахождении наибольшей возрастающей подпоследовательности в массиве длины $$$n$$$ и элементами от $$$0$$$ до $$$N$$$ за $$$O(n \cdot log(N))$$$ времени. При желании Вы можете придумать его сами или посмотреть решение ниже
Итак, теперь мы можем переходить к задаче F. Коротко повторю условия и немного их перефразирую для удобства: нам дан массив $$$a$$$ длины $$$n \leq 2 \cdot 10^5$$$ с элементами от $$$1$$$ до $$$10^6$$$. Изначально курсор стоит на индексе $$$0$$$, а также нам приходит $$$m \leq 5 \cdot 10^5$$$ запросов. За один запрос мы можем переместить курсор влево или вправо на 1, либо изменить значение массива $$$a$$$ в индексе, на который указывает курсор, на новое число $$$x$$$. После каждого запроса изменения числа нужно вывести длину наибольшей возрастающей подпоследовательности (Longest Increasing Subsequence, далее LIS) нового массива $$$a$$$
То, что за один запрос разрешено двигать курсор только на 1 позицию, наталкивает на мысль, что мы должны поддерживать какую-то информацию о префиксе перед курсором и о суффиксе, который идёт после курсора. Для удобства обозначим за $$$A$$$ префикс $$$a$$$ до элемента $$$a[cur]$$$ не включительно, а за $$$B$$$ суффикс $$$a$$$, начиная с элемента $$$a[cur + 1]$$$ включительно, где $$$cur$$$ — текущее значение курсора. То есть $$$a = A + a[cur] + B$$$
Ну раз уж мы знаем про прекрасное решение задачи о нахождении LIS, давайте хранить ровно ту же информацию в двух деревьях отрезков. Дерево отрезков для префикса будет хранить массив $$$sta$$$, где $$$sta[x]$$$ — это длина LIS в $$$A$$$, последний элемент которой равен $$$x$$$. Если таких подпоследовательностей не существует, $$$sta[x] = 0$$$. Аналогично, $$$stb$$$ — массив для суффикса, в котором $$$stb[y]$$$ — это длина LIS в $$$B$$$, первый элемент которой равен $$$y$$$
Вопрос 1: как обновлять деревья отрезков для sta и stb при перемещении курсора на 1 позицию?
Итак, теперь мы умеем обрабатывать запросы сдвига курсора влево и вправо. Осталось только научиться считать ответ
Вопрос 2: как посчитать длину LIS, проходящей через $$$a[cur]$$$?
Теперь перейдём к более сложной части, а именно к подсчёту LIS, не проходящих через $$$a[cur]$$$
Вопрос 3: как выражается эта длина в терминах $$$sta$$$ и $$$stb$$$?
Теперь, раз мы понимаем как выражается ответ, мы его можем посчитать наивным образом за $$$O(N^2)$$$
Вопрос 4: как ускорить подсчёт ответа?

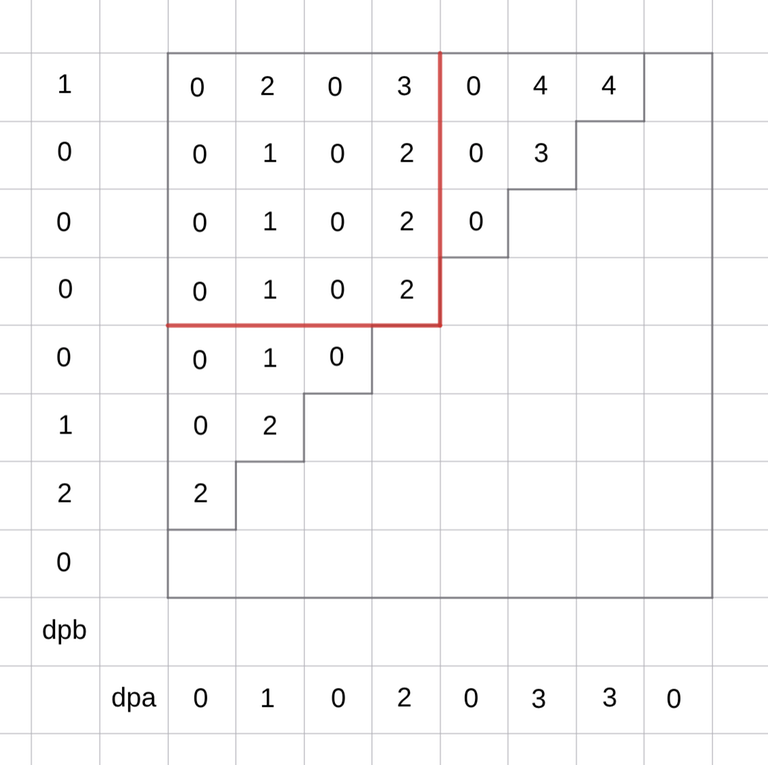

Мы научились считать максимум на этом треугольнике за $$$O(N)$$$, но это всё равно очень долго. С другой стороны, эта таблица практически не меняется при изменении одного элемента $$$sta$$$ или $$$stb$$$
Вопрос 5: как пересчитывать максимум на треугольнике при изменении одного элемента $$$sta$$$ или $$$stb$$$?
Итого, мы за $$$O(log(N))$$$ умеем считать LIS, среди всех, кто проходит через $$$a[cur]$$$ и за столько же LIS среди всех, кто не проходит через $$$a[cur]$$$. Чтобы посчитать итоговый LIS, нужно просто взять максимум из этих двух значений
Итоговая сложность решения по времени $$$O(m \cdot log(N))$$$ — хватит с запасом при данных ограничениях


 Comments (0)


