Как вы поняли, этот пост посвящён задаче F с прошедшего полуфинала ICPC CERC 2025
Эта задача не так проста, поэтому, чтобы додуматься до решения, необходимо знать две вещи:
- Структуру данных "Дерево отрезков"
- Решение задачи о нахождении наибольшей возрастающей подпоследовательности в массиве длины $$$n$$$ и элементами от $$$0$$$ до $$$N$$$ за $$$O(n \cdot log(N))$$$ времени. При желании Вы можете придумать его сами или посмотреть решение ниже
Нахождение наибольшей возрастающей подпоследовательностиФормально, пускай нам дан массив $$$a$$$ размера $$$n$$$, такой, что для $$$0 \leq i \lt n$$$ верно $$$0 \leq a[i] \lt N$$$. Требуется найти длину наибольшей возрастающей подпоследовательности массива $$$a$$$
Конечно же решение использует метод динамического программирования. Мы будем рассматривать элементы $$$a[i]$$$ в порядке увеличения индекса $$$i$$$ и хранить массив $$$dp$$$ размера $$$N$$$, так, что $$$dp[x]$$$ равно наибольшей возрастающей подпоследовательности, последний элемент которой ровно $$$x$$$. Тогда, если массив рассчитан корректно для шага $$$i-1$$$, мы можем посчитать длину наибольшей возрастающей подпоследовательности, которая заканчивается в $$$a[i]$$$ как $$$cnt = 1 + \max\limits_{0 \leq x \lt a[i]} (dp[x])$$$, так как предыдущее число в подпоследовательности должно быть меньше $$$a[i]$$$. Теперь, если $$$cnt \gt dp[a[i]]$$$, нужно обновить $$$dp[a[i]] := cnt$$$
В процессе пересчёта массива $$$dp$$$ нам потребовалось две операции: получение максимума элементов массива на отрезке и изменение одного элемента. Обе эти операции можно делать деревом отрезков за $$$O(log(N))$$$ на одну операцию
Так как мы каждую операцию вызываем не более $$$n$$$ раз, получается сложность по времени $$$O(n \cdot log(N))$$$
Заметим, что мы могли итерироваться не по возрастанию индексов, а по убыванию, и считать длину наибольшей возрастающей подпоследовательности, которая начинается с элемента, равного x, а не начинается. Такой подход тоже даст верный ответ
Итак, теперь мы можем переходить к задаче F. Коротко повторю условия и немного их перефразирую для удобства: нам дан массив $$$a$$$ длины $$$n \leq 2 \cdot 10^5$$$ с элементами от $$$1$$$ до $$$10^6$$$. Изначально курсор стоит на индексе $$$0$$$, а также нам приходит $$$m \leq 5 \cdot 10^5$$$ запросов. За один запрос мы можем переместить курсор влево или вправо на 1, либо изменить значение массива $$$a$$$ в индексе, на который указывает курсор, на новое число $$$x$$$. После каждого запроса изменения числа нужно вывести длину наибольшей возрастающей подпоследовательности (Longest Increasing Subsequence, далее LIS) нового массива $$$a$$$
То, что за один запрос разрешено двигать курсор только на 1 позицию, наталкивает на мысль, что мы должны поддерживать какую-то информацию о префиксе перед курсором и о суффиксе, который идёт после курсора. Для удобства обозначим за $$$A$$$ префикс $$$a$$$ до элемента $$$a[cur]$$$ не включительно, а за $$$B$$$ суффикс $$$a$$$, начиная с элемента $$$a[cur + 1]$$$ включительно, где $$$cur$$$ — текущее значение курсора. То есть $$$a = A + a[cur] + B$$$
Ну раз уж мы знаем про прекрасное решение задачи о нахождении LIS, давайте хранить ровно ту же информацию в двух деревьях отрезков. Дерево отрезков для префикса будет хранить массив $$$sta$$$, где $$$sta[x]$$$ — это длина LIS в $$$A$$$, последний элемент которой равен $$$x$$$. Если таких подпоследовательностей не существует, $$$sta[x] = 0$$$. Аналогично, $$$stb$$$ — массив для суффикса, в котором $$$stb[y]$$$ — это длина LIS в $$$B$$$, первый элемент которой равен $$$y$$$
Вопрос 1: как обновлять деревья отрезков для sta и stb при перемещении курсора на 1 позицию?
Подсказка 1.1Посмотрите "Решение задачи о нахождении LIS", чтобы понять, как обрабатывать удлинение префикса/суффикса
Ответ 1.1Если мы добавляем элемент $$$a[cur]$$$ к префиксу $$$A$$$, то нам нужно посчитать $$$cnt = 1 + \max\limits_{0 \leq x \lt a[cur]} sta[x]$$$. Если $$$cnt \gt sta[a[cur]]$$$, обновляем $$$sta[a[cur]] := cnt$$$
Если мы добавляем элемент $$$a[cur]$$$ к суффиксу $$$B$$$, то нам, аналогично, нужно посчитать $$$cnt = 1 + \max\limits_{a[cur] + 1 \leq y \lt N} stb[y]$$$. Если $$$cur \gt stb[a[cur]]$$$, обновляем $$$stb[a[cur]] := cnt$$$
Подсказка 1.2Заметим, что когда мы удаляем элемент из префикса/суффикса, мы "откатываем" последнее обновление, которое сделали. А именно — увеличение максимума. Поэтому давайте придумаем, как хранить историю изменений прямо в Дереве отрезков
Ответ 1.2Давайте запоминать в листе Дерева отрезков не только текущее значение, но и все такие значения, которые не меньше своих предшественников. Будем хранить их в стэке, чтобы было удобно изменять значение на предыдущее. Теперь $$$sta[x]$$$ — это верхнее значение в вершине дерева, соответствующего индексу $$$x$$$. Изначально в стэке лежит только $$$0$$$
Теперь наша операция изменения распалась на две разные операции:
$$$add(x, val)$$$ — если $$$sta[x] \leq val$$$ — добавляем val в стэк вершины x сверху $$$del(x, val)$$$ — если $$$sta[x] == val$$$ — убираем из стэка вершины x элемент
А процедура удаления элемента $$$a[cur - 1]$$$ из префикса $$$A$$$ выглядит совсем просто. Посчитаем уже запомнившееся всем $$$cnt = 1 + \max\limits_{0 \leq x \lt a[cur - 1]} sta[x]$$$ — это ровно то значение, которое мы считали при добавлении $$$a[cur - 1]$$$ в префикс. Теперь если $$$sta[a[cur - 1]] == cnt$$$, значит мы делали соответствующее обновление операцией $$$add(a[cur - 1], cnt)$$$ и его нужно удалить со стэка, иначе значение не обновлялось и стэк трогать не нужно
Для массива $$$stb$$$ требуются аналогичные действия
Замечание. Попробуйте понять почему в операции $$$add$$$ нельзя заменить условие $$$sta[x] \leq val$$$ на $$$sta[x] \lt val$$$
Итак, теперь мы умеем обрабатывать запросы сдвига курсора влево и вправо. Осталось только научиться считать ответ
Вопрос 2: как посчитать длину LIS, проходящей через $$$a[cur]$$$?
Подсказка 2Заметим, что если подпоследовательность проходит через $$$a[cur]$$$, то все её элементы в $$$A$$$ строго меньше $$$a[cur]$$$, а все элементы в $$$B$$$ строго больше, чем $$$a[cur]$$$
Ответ 2Из подсказки следует вывод о том, что длина такой последовательности равна $$$1 + \max\limits_{0 \leq x \lt a[cur]} sta[x] + \max\limits_{a[cur] + 1 \leq x \lt N} stb[x]$$$, так как часть такой подпоследовательности, находящейся в $$$A$$$, заканчивается на элемент $$$x \lt a[cur]$$$, а часть в $$$B$$$ начинается на элемент $$$y \gt a[cur]$$$. И $$$+1$$$ за счёт того, что сам элемент также участвует в последовательности
Теперь перейдём к более сложной части, а именно к подсчёту LIS, не проходящих через $$$a[cur]$$$
Вопрос 3: как выражается эта длина в терминах $$$sta$$$ и $$$stb$$$?
Ответ 3Обозначим последний элемент подпоследовательности, находящийся в $$$A$$$, через $$$x$$$. А первый элемент подпоследовательности, находящийся в $$$B$$$, через $$$y$$$. При этом $$$x \lt y$$$. Поэтому длина максимальной возрастающей подпоследовательности равна $$$\max\limits_{0 \leq x \lt y \lt N} sta[x] + stb[y]$$$
Теперь, раз мы понимаем как выражается ответ, мы его можем посчитать наивным образом за $$$O(N^2)$$$
Вопрос 4: как ускорить подсчёт ответа?
Подсказка 4.1Давайте расположим естественным образом в квадрате $$$N \times N$$$ наши элементы $$$sta[x] + stb[y]$$$ — в клетке $$$(x, y)$$$ расположено значение $$$sta[x] + stb[y]$$$. Ниже на рисунке нарисована такая таблица и оба массива $$$sta$$$ и $$$stb$$$, в тех клетках, где $$$x \lt y$$$ написана сумма. Нам нужно вычислить максимум на таком треугольнике из клеточек

Подсказка 4.2Почему задача поиска максимума на треугольнике не является очевидной? Каким был бы ответ, если бы нам нужно было найти максимум на прямоугольнике?
Ответ 4.2Для ответа на вопрос выше воспользуемся необычным устройством нашей таблицы. Если бы нам нужно было бы вычислить максимум на прямоугольнике $$$[lx, rx) \times [ly, ry)$$$, нужно было просто посчитать $$$\max\limits_{lx \leq x \lt rx} sta[x] + \max\limits_{ly \leq y \lt ry} stb[y]$$$, так как чтобы посчитать максимальную сумму в такой таблице — достаточно вычислить максимумы слагаемых
Подсказка 4.3Можно ли воспользоваться этим свойством, чтобы свести задачу к более простой, если заметить большой прямоугольник внутри нашего треугольника?
Ответ 4.3Раз уж мы легко умеем считать максимум на прямоугольнике, давайте выделим большой прямоугольник слева сверху как на рисунке и посчитаем максимум на нём
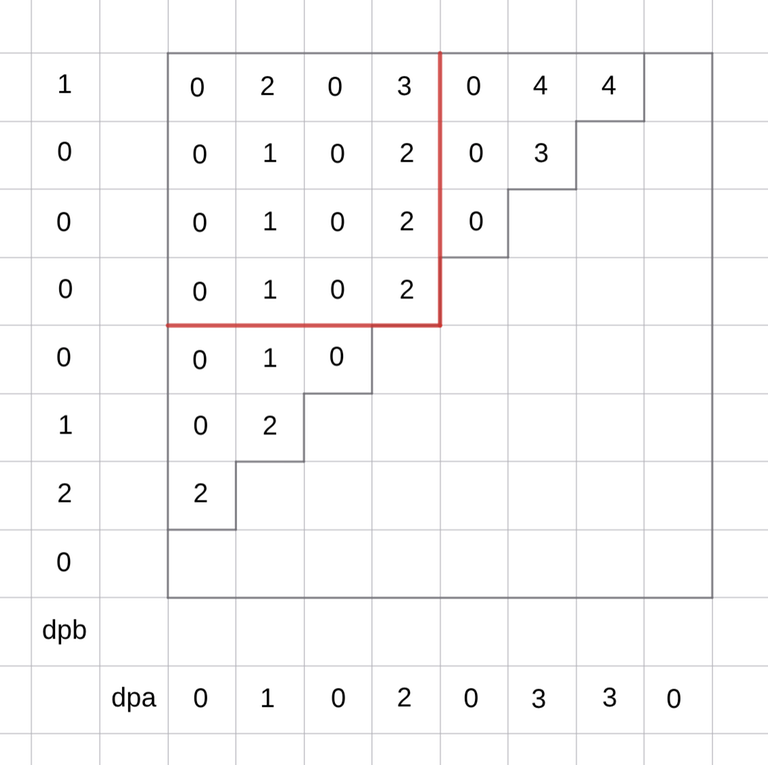
Замечание. Так как в задаче в качестве $$$N$$$ мы можем выбрать любое число, большее $$$10^6$$$, давайте выберем степень двойки для удобства
Теперь ответ для большого треугольника представляется как максимум из ответа для прямоугольника и максимумов для маленьких оставшихся треугольничков — нижнего и правого, сторона которых в два раза меньше, чем у исходного
Запустим рекурсивный подсчёт, в котором будет $$$log(N)$$$ уровней. На первом уровне мы вычислим максимум на $$$1$$$ прямоугольнике, на втором уровне на $$$2$$$ прямоугольниках, на третьем на $$$4$$$-ех и так далее. Итого мы вычислим ответ на $$$O(N)$$$ (а если быть совсем уж точным, то на N — 1 прямоугольнике, смотри рисунок) прямоугольниках

Каждое вычисление работает за $$$O(log(N))$$$, так как у нас построены деревья отрезков на массивах $$$sta$$$ и $$$stb$$$. Итого пересчёт работает за $$$O(N \cdot log(N))$$$
Подсказка 4.4Как избавиться от логарифмического множителя в асимптотике? Заметим, что он получается из-за запросов в Дерево Отрезков. А ещё заметим тот факт, что наши запросы имеют чёткую структуру
Ответ 4.4Обратим внимание на то, что так как при переходе к меньшему прямоугольнику мы делим сторону ровно пополам, ответ на наш запрос всегда целиком находится в одной вершине дерева отрезков для массива $$$sta$$$ и $$$stb$$$, поэтому максимум на таких отрезках мы можем вычислять за $$$O(1)$$$. Итого получается подсчёт максимума на треугольнике за $$$O(N)$$$
Мы научились считать максимум на этом треугольнике за $$$O(N)$$$, но это всё равно очень долго. С другой стороны, эта таблица практически не меняется при изменении одного элемента $$$sta$$$ или $$$stb$$$
Вопрос 5: как пересчитывать максимум на треугольнике при изменении одного элемента $$$sta$$$ или $$$stb$$$?
Подсказка 5.1При таком действии в таблице меняется один столбец или одна строка. Сколько треугольников задевает такое изменение?
Ответ 5.1Наверняка Вы поняли по подсказке, что такое изменение задевает не более $$$log(N)$$$ треугольников, потому что строка или столбец пересекает максимум один треугольник на каждом уровне построения треугольников (ответ 4.3). Получается, теоретически возможно пересчитать ответ во всех изменившихся треугольниках за $$$O(log(N))$$$
Подсказка 5.2Как же пересчитать ответ для всех изменившихся треугольников быстро?
Ответ 5.2Заметим, что если изменился маленький треугольник, то изменился треугольник вдвое большего размера, который его содержит. Тогда нам достаточно найти наименьший изменившийся треугольник и проитерироваться по всем содержащим его треугольникам. Кстати, это тоже можно реализовать через дерево отрезков
Тогда мы можем пересчитывать ответ за $$$O(log(N))$$$ на запрос, что нам и требовалось
Итого, мы за $$$O(log(N))$$$ умеем считать LIS, среди всех, кто проходит через $$$a[cur]$$$ и за столько же LIS среди всех, кто не проходит через $$$a[cur]$$$. Чтобы посчитать итоговый LIS, нужно просто взять максимум из этих двух значений
Итоговая сложность решения по времени $$$O(m \cdot log(N))$$$ — хватит с запасом при данных ограничениях


Можно и другой алгоритм для поиска LIS приспособить, так дерево отрезков не пригодится.
А именно, вспомним следующий алгоритм для поиска LIS: для каждого префикса насчитаем $$$\mathrm{dp}$$$, где $$$\mathrm{dp}_i$$$ — наименьший элемент, на который заканчивается возрастающая подпоследовательность длины $$$i$$$ (или $$$\infty$$$, если такой нет). Чтобы пересчитать $$$\mathrm{dp}$$$ для нового префикса, добавив в конец старого префикса $$$x$$$, надо записать на позиции
dp.lower_bound(x)сам элемент $$$x$$$.Для решения задачи будем поддерживать $$$\mathrm{dp\_pref}$$$ (для префикса, как выше) и симметричный $$$\mathrm{dp\_suf}$$$ (для суффикса, $$$\mathrm{dp\_suf}_i$$$ — наибольший элемент, на который начинается возрастающая подпоследовательность длины $$$i$$$, или $$$-\infty$$$). Когда курсор сдвигается вправо, $$$\mathrm{dp\_pref}$$$ пересчитывается бинпоиском, как выше, а в $$$\mathrm{dp\_suf}$$$ происходит откат (надо хранить для каждого из этих двух $$$\mathrm{dp}$$$ стек изменений). Когда влево, то наоборот.
Теперь научимся отвечать на запросы. Пусть $$$\mathrm{dp\_pref}_i \lt \mathrm{dp\_suf}_j$$$, тогда мы знаем, что ответ хотя бы $$$i+j$$$. Чтобы решить задачу, нужно уметь эффективно поддерживать это множество пар $$$(i, j)$$$. Будем поддерживать только углы: такие пары $$$(i, j)$$$, что
dp_pref[i] < dp_suf[j] && dp_pref[i+1] >= dp_suf[j] && dp_pref[i] >= dp_suf[j+1]. Для каждого $$$i$$$ существует не более одного $$$j$$$, такого, что $$$(i, j)$$$ — угол, и для каждого $$$j$$$ — не более одного $$$i$$$. Значит, когда курсор сдвигается, надо обновить $$$\mathcal{O}(1)$$$ пар. А именно, если изменилось $$$\mathrm{dp\_pref}_i$$$, то сначала удаляем старые углы с первой координатой $$$i-1$$$ или $$$i$$$, а потом заново высчитываем бинпоиском углы с такой первой координатой, и если они есть, то добавляем. Тут надо быть достаточно аккуратным, так как нужна какая-то структура (подойдут два массива), которая по $$$i$$$ ищет углы $$$(i, j)$$$, по $$$j$$$ ищет те же углы, и при обновлении всё это обновляет.Ну и наконец будем поддерживать например мультисет со всевозможными ответами (суммами $$$i + j$$$ для углов $$$(i, j)$$$, и на запрос выводить наибольший. Вот посылка
Действительно, классное решение!