



За последнее время у меня набралось определённое количество заметок на различные темы, с которыми до конца не ясно что делать. Скорее всего, для синих эта информация не слишком актуальна, для красных — давно очевидна. Из этих заметок вряд ли получится сделать статьи, а достаточно заинтересованный человек вполне может собрать всю приведённую в них информацию из интернета по частям самостоятельно. Тем не менее, я всё же решил сделать пост (или, может быть несколько) на Codeforces, в надежде, что эти сведения для кого-нибудь окажутся полезными.
Оригинальная задача KQUERY формулируется следующим образом. Дан массив  размера
 , а также
 запросов вида
 — определить количество элементов, больших
 , на отрезке
 .
Сразу следует заметить, что из-за достаточно малого TL вердикт Accepted по оригинальной задаче получает только одно из приведённых ниже решений. Тем не менее, рассмотрение альтернативных подходов к задаче также не лишено смысла.
Online-версия задачи KQUERY — KQUERYO. Среди её особенностей — увеличенный TL и некорректные тесты (см. комментарии к задаче). Все показанные online-решения получают применительно к данной задаче вердикт Accepted.
Dynamic-версия задачи KQUERY — KQUERY2. В данном посте эта задача (пока) не рассматривается; её обсуждение можно найти здесь.
Решение #1: merge tree
Препроцессинг  , ответ на запрос
 , online
Создадим дерево отрезков, у которого в вершине, соответствующей подотрезку  , хранится отсортированный вектор элементов массива
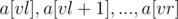 (в иностранных источниках такое дерево отрезков иногда называют merge tree). Объединять отсортированные вектора можно при помощи алгоритма STL merge().
При обработке запроса к отрезку  мы, как обычно, спускаемся к вершинам, подотрезки которых входят в целевой отрезок, и в каждой из этих вершин выполняем двоичный поиск, чтобы определить количество элементов, больших .
Решение #1a: частичное каскадирование
Препроцессинг , ответ на запрос  , online
В предыдущем решении мы использовали двоичный поиск, чтобы в каждой вершине, подотрезок которой входит в отрезок запроса, находить индекс первого элемента, большего . Мы могли бы определять этот индекс за  , если бы в каждой вершине была сохранена дополнительная информация.
Пусть  — отсортированный вектор, хранящийся в вершине
 ,
 и
 — отсортированные вектора, хранящиеся в её левом и правом потомках. Пусть в вершине также имеются массивы
 и
 , такие что
 — индекс первого элемента, большего или равного
 , в массиве ,
 — аналогичный индекс в массиве . Тогда, зная индекс
 первого элемента, большего , в массиве вершины , мы за определяем индекс первого элемента, большего , в массивах вершин-потомков (это и ).
Массивы и формируются в функции build(), когда выполняется объединение двух отсортированных массивов в один. Можно выполнять это объединение вручную, как в сортировке слиянием, попутно заполняя массивы и .
При обработке запроса достаточно выполнить бинпоиск в корневой вершине, чтобы найти индекс первого элемента, большего , а далее обновлять его значениями из и . Данную технику называют частичным каскадированием (fractional cascading), она позволяет снять лишний логарифм при обработке запросов.
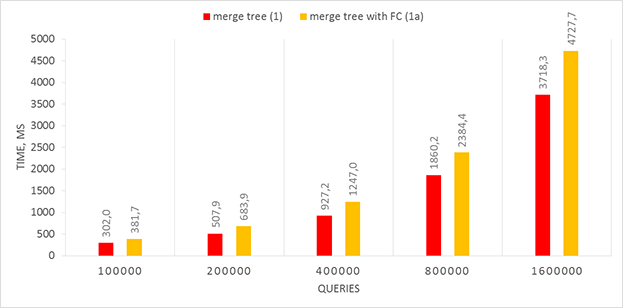
Практика, однако, показывает, что несмотря на лучшую асимптотическую оценку, данное решение работает на 30-40% медленнее предыдущего, поэтому пользоваться им не стоит.
Решение #2: сканирующая прямая по значениям (ординатам)
Препроцессинг 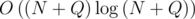 , ответ на запрос , offline
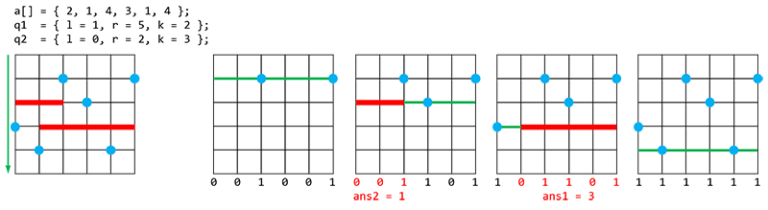
Рассмотрим геометрическую интерпретацию исходной задачи. Если элементы массива представить на плоскости в виде точек  , то ответом на запрос является количество точек, лежащих выше отрезка
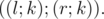
Введём два вида событий: появление точки и появление запроса. Отсортируем все события в порядке убывания ординат (для точек это  , для запросов — ). По абсциссам построим стандартное дерево отрезков для суммы, в котором будем отмечать появление точек.
При обработке появления точки присваиваем в дереве отрезков единицу её абсциссе . При обработке появления запроса определяем сумму на отрезке . Заметим, что если разные события имеют одинаковую ординату, в первую очередь должны обрабатываться события, связанные с запросами.
Решение #3: сканирующая прямая по индексам (абсциссам)
Препроцессинг , ответ на запрос 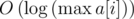 , offline
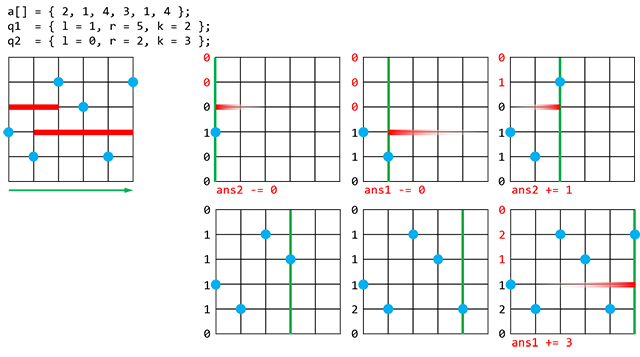
Продолжим использовать ту же геометрическую интерпретацию задачи, что и для предыдущего решения, но теперь сканирующая прямая движется не сверху вниз, а слева направо.
Введём три вида событий: появление точки, начало запроса, конец запроса. Отсортируем все события в порядке возрастания абсцисс (для точек это , для начал запросов —  , для концов запросов —
 ). По ординатам построим стандартное дерево отрезков для суммы, в котором будем отмечать появление точек.
При обработке появления точки присваиваем в дереве отрезков единицу её ординате . При обработке начала запроса вычитаем из ответа сумму на отрезке  , при обработке конца запроса добавляем к ответу сумму на отрезке . Если разные события имеют одинаковую абсциссу, сначала обрабатываются начала запросов, затем точки, затем концы запросов.
Решение #3a: неявное дерево отрезков
Препроцессинг , ответ на запрос 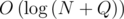 , offline
Используем сжатие координат или неявное дерево отрезков, чтобы снизить потребление памяти с  до
 . Время обработки запроса при этом сократится от до .
Неявное дерево отрезков строится не в массиве, а полностью на указателях. Новые вершины создаются только в том случае, если к ним обращается функция модификации дерева.
Решение #3b: персистентное дерево отрезков
Препроцессинг , ответ на запрос , online
Оставим в геометрической интерпретации только точки и сохраним версии неявного дерева отрезков для каждого индекса . Каждая новая версия не дублирует все вершины предыдущей, а добавляет только изменённых вершин.
Для ответа на запрос требуется вычислить сумму на отрезке  в версии и вычесть сумму на отрезке в версии
 .
Решение #4: sqrt-декомпозиция
Препроцессинг , ответ на запрос 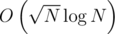 , online
Разделим исходный массив на блоки размером  (получится
 блоков). Отсортируем каждый из блоков.
Пусть выполняется запрос к отрезку  . В тех блоках, которые полностью покрываются отрезком запроса, количество чисел, больших , может быть найдено двоичным поиском. На концах отрезка , не покрывающих полностью соответствующие блоки (а также в том случае, когда и принадлежат одному блоку), ответ считается наивным методом за линейное время. Таким образом, время ответа на запрос выражается как
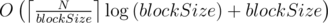 .
При 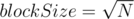 получаем классическую sqrt-декомпозицию, имеющую время обработки запроса . Можно попытаться улучшить это значение, подобрав размер так, чтобы минимизировать выражение
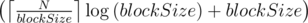 . При
 таким значением будет
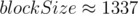 . Тем не менее, фактическое увеличение производительности по сравнению с sqrt-декомпозицией составляет ~5%, что влечёт общую нецелесообразность подобной оптимизации.
Сравнение быстродействия решений
Сформируем массив размера  , заполненный случайными числами из диапазона
 . Затем выполним
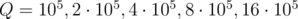 случайных KQUERY-запросов к данному массиву. Для каждого значения
 произведём 10 тестов, в качестве итогового времени возьмём среднее.
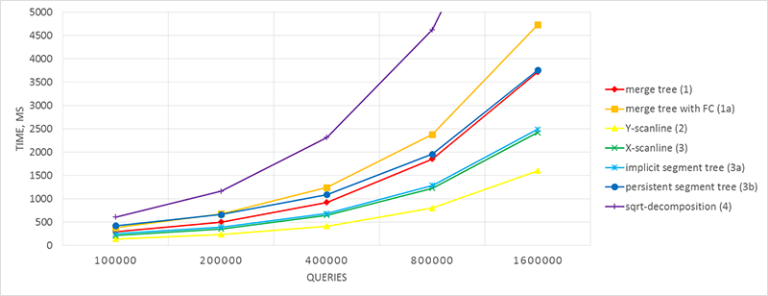
Можно видеть, что наиболее быстрым из online-решений является использование дерева отрезков с отсортированными подмассивами в вершинах, имеющее асимптотику на запрос (!).
Как было упомянуто ранее, в оригинальной задаче KQUERY вердикт Accepted получает только offline-решение #2 (сканирующая прямая по убыванию ординат). Можно попробовать произвести (неасимптотические) оптимизации других решений: не использовать ООП-стиль, заменить std::vector на статические массивы и т. д. Описание оптимизаций, достойных внимания, приветствуется в комментариях.
Другие задачи, сводящиеся к KQUERY
Количество различных чисел на отрезке (DQUERY)
Существует простое сведение задачи DQUERY к задаче KQUERY за время 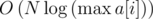 .
Определим массив  , такой что
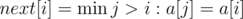 . Другими словами, -й элемент массива содержит индекс следующего справа элемента, равного (если — последнее появление элемента, то
 ).
Количество различных элементов на отрезке — это количество элементов, справа от которых на отрезке нет равных им, то есть количество таких  , что
 . Таким образом, результат запроса DQUERY
 к массиву равен результату запроса KQUERY
 к массиву .
На spoj.com задачу DQUERY можно сдать с использованием любого из показанных выше решений, кроме самого медленного (#4, sqrt-декомпозиция).
Обсуждение задачи на Codeforces
K-я порядковая статистика на отрезке (MKTHNUM)
Используя бинарный поиск по ответу, любое online-решение задачи KQUERY можно преобразовать в решение задачи MKTHNUM, асимптотика которого будет в 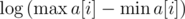 раз выше: из решений KQUERY с асимптотикой и получаются решения MKTHNUM с асимптотикой
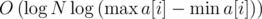
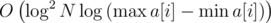 соответственно.
На spoj.com задачу MKTHNUM можно сдать с использованием любого из online-решений, кроме самого медленного (#4, sqrt-декомпозиция). В решении #3b нужно аккуратно учитывать отрицательные элементы массива.
Важно, что эта задача имеет online-решение с временем обработки запроса . Это решение (не рассматриваемое здесь подробно) получается из решения #3b, но вместо бинарного поиска по ответу используется параллельный спуск по деревьям отрезков версий и .
Обсуждение задачи на Codeforces
Решения указанных задач также приведены в лекции ЗКШ 2015 (автор Burunduk1).


 Comments (0)


