


2284A1 - 15K4JR3B (простая версия)
Достаточно применять операции только к двум точкам.
Докажем, что максимальная площадь достигается, если мы сдвинем одну из точек на $$$\lfloor \frac{n}{2} \rfloor$$$ шагов вверх, а другую на $$$\lceil \frac{n}{2} \rceil$$$ шагов вправо. Для этого рассмотрим прямоугольник, описывающий получившийся треугольник после всех сдвигов точек; пусть его стороны равны соответственно $$$a$$$ и $$$b$$$. Покажем, что его максимальная площадь равна как раз $$$\frac{ab}{2}$$$. Поскольку треугольник $$$ABC$$$ вписан в наш прямоугольник, хотя бы одна его вершина должна совпасть с вершиной прямоугольника. Без ограничения общности будем считать, что это вершина $$$A$$$. Если обозначить прилежащие к ней углы за $$$\alpha$$$ и $$$\beta$$$, можно показать, что наибольшая площадь будет достигнута, когда значение $$$\text{tg}\,\alpha \cdot \text{tg}\,\beta$$$ минимально, то есть равно $$$0$$$ при $$$0 \le \alpha + \beta \lt \frac{\pi}{2}$$$.
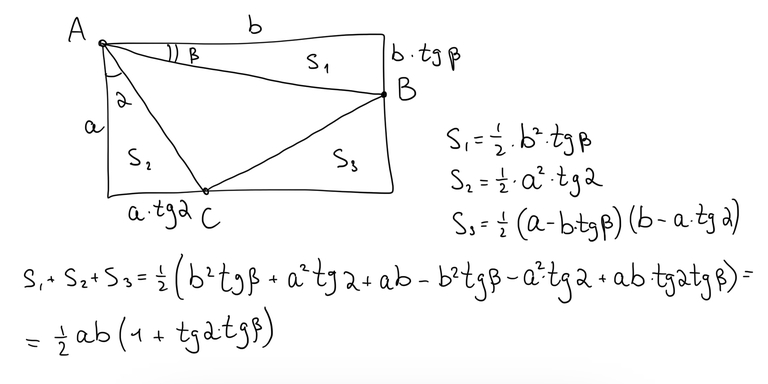
Это как раз означает, что наибольшая площадь будет достигаться, когда хотя бы две вершины треугольника будут совпадать с вершинами рассматриваемого прямоугольника, что уже будет гарантировать нам площадь, равную половине площади прямоугольника. Последним шагом заметим, что единственным ограничением на $$$a$$$ и $$$b$$$ для нас является их сумма $$$a + b \le n$$$, а значит, нам выгодно сделать $$$a + b = n$$$ с произведением $$$ab \le \lfloor \frac{n}{2} \rfloor \lceil \frac{n}{2} \rceil$$$.
def INT(): return int(input())
def MAP(): return map(int, (input().split()))
def MAT(n): return [list(map(int, (input().split()))) for _ in range(n)]
for _ in range(INT()):
    n=INT()
    print((n>>1)*((n+1)>>1))
2284A2 - 15K4JR3B (сложная версия)
Обычно в задачах со степенями двойки в том или ином виде возникает идея жадной оптимизации.
Заметим, что все рассуждения из простой версии применимы и к сложной, только теперь мы должны придумать, как достичь минимальной абсолютной разности между суммой сдвигов по обеим осям. В общем виде для произвольных сдвигов эта задача является $$$\text{NP}$$$-трудной, но поскольку мы рассматриваем степени двойки, ее можно решить жадно: заведем два счетчика, равных $$$0$$$, и будем идти по отсортированному массиву степеней в обратном порядке, увеличивая счетчик с меньшей суммой на текущую степень. Идейно это работает, поскольку у малых степеней выше степень свободы при минимизации абсолютной разности. С более строгими рассуждениями вы можете ознакомиться ниже.
Формально пусть текущие суммы счетчиков равны $$$a \lt b$$$, а их разность $$$m = b - a$$$. Пусть наибольшая еще не рассмотренная степень двойки равна $$$d = 2^k$$$, $$$p$$$ — сумма всех остальных нерассмотренных степеней, в оптимальном разбиении попавших в счетчик $$$a$$$, а $$$q$$$ — сумма всех остальных еще нерассмотренных степеней, попавших в счетчик $$$b$$$. Поскольку значение $$$m$$$ было получено при обработке только степеней, не меньших $$$d$$$, оно также кратно $$$d$$$, а значит $$$d \le m$$$. Предположим, что в некотором оптимальном разбиении элемент $$$d$$$ добавляется к большему счетчику $$$b$$$.
Обозначим $$$t = p - q$$$. Если $$$t \le m$$$, то перенос $$$d$$$ в счетчик $$$a$$$ не увеличит итоговую разность, так как $$$|m - d - t| \le |m + d - t|$$$.
Если же $$$t \gt m$$$, то $$$p \gt m \ge d$$$. Поскольку все элементы, входящие в сумму $$$p$$$ являются степенями двойки, не превосходящими $$$d$$$, среди них всегда можно выбрать подмножество с суммой ровно $$$d$$$. Обменяем это подмножество с текущим элементом $$$d$$$. Итоговые суммы групп не изменятся, но $$$d$$$ окажется в сумме меньшего счетчика $$$a$$$.
Если же изначально счетчики $$$a$$$ и $$$b$$$ равны, мы вольны добавить степень $$$d$$$ к любому из них.
Таким образом, если зафиксировать некоторое оптимальное решение и последовательно рассматривать степени двойки от большей к меньшей, мы гарантированно сможем такими шагами получить жадное решение, которое будет не хуже исходного, то есть также является оптимальным.
def INT(): return int(input())
def MAP(): return map(int, (input().split()))
def MAT(n): return [list(map(int, (input().split()))) for _ in range(n)]
for _ in range(INT()):
    n=INT()
    a=sorted(MAP(),reverse=True)
    rs0,rs1=0,0
    for el in a:
        if rs0<=rs1:rs0+=1<<el
        else:rs1+=1<<el
    print(rs0*rs1)
2284B - Введение в нижний интернет
Подумайте, какие донаты являются весьма приятными независимо от своего положения.
Такими донатами будут все донаты, равные $$$\max(a)$$$, то есть если максимумов больше $$$k$$$, ответ заведомо равен $$$\text{NO}$$$. Но что если максимум встречается в массиве не более $$$k$$$ раз?
Заметим, что любой донат размера $$$\max(a)$$$ заведомо является весьма приятным, поскольку он, очевидно, будет не меньше среднего значения любого подмножества элементов массива. Значит, если максимум встречается в массиве более $$$k$$$ раз, ответ равен $$$\text{NO}$$$. В противном случае отсортируем массив $$$a$$$ по неубыванию и разрежем его на два массива $$$b$$$ и $$$c$$$ длины $$$n - k$$$ и $$$k$$$ соответственно. Теперь выпишем сначала элементы $$$c$$$ в прямом, а затем элементы $$$b$$$ в обратном порядке.
Покажем, что полученный массив удовлетворяет требуемому условию. Поскольку элементы $$$c$$$ идут по неубыванию, каждый из них не меньше всех предыдущих, а значит, и не меньше их среднего арифметического, поэтому все первые $$$k$$$ донатов точно окажутся весьма приятными. Теперь рассмотрим первый элемент второй части $$$b_1$$$. Среднее значение предшествующего ему префикса будет строго больше $$$b_1$$$, так как все элементы $$$c$$$ не меньше него, при этом сам $$$b_1$$$ меньше максимума, содержащегося в $$$c$$$. Все последующие донаты $$$b_2, b_3, \dots$$$ также не будут весьма приятными, поскольку элементы $$$b$$$ идут по невозрастанию и среднее арифметическое префикса каждый раз будет оставаться строго больше очередного рассматриваемого элемента.
Асимптотика решения $$$O(n \log n)$$$ на сортировку.
def INT(): return int(input())
def MAP(): return map(int, (input().split()))
def MAT(n): return [list(map(int, (input().split()))) for _ in range(n)]
for _ in range(INT()):
    n,k=MAP()
    a=sorted(MAP())
    if a.count(a[-1])>k:
        print('nO')
        continue
    b=a[:n-k]
    c=a[n-k:]
    b=reversed(b)
    print('yEs')
    print(*c,*b)
2284C1 - Омерзительно + GCD (конструктивная версия)
$$$\gcd(a, x) = 1 \iff \gcd(a, a + x) = 1$$$
На самом деле нам хватит не более $$$n$$$ операций.
Заметим, что, если массив состоит только из простых чисел, он не является омерзительным, поскольку для любой пары элементов их $$$\gcd$$$ будет равен либо $$$1$$$, либо им самим.
Давайте попробуем заменить каждый из элементов $$$a_i$$$ на наименьшее простое $$$p \gt a_i$$$. Очевидно, что мы не израсходуем лимит операций, поскольку раз $$$\gcd(a_i, p) = 1$$$, то и $$$\gcd(a[i], p - a[i]) = 1$$$, то есть на одну замену мы потратим ровно $$$1$$$ операцию.
Таким образом, единственным оставшимся ограничением для нас является сумма элементов полученного массива $$$b$$$. Однако из постулата Бертрана следует, что для любого положительного $$$n$$$ отрезок $$$[n + 1, 2n]$$$ содержит хотя бы одно простое число, а значит, после замены сумма всех элементов массива $$$b$$$ не превысит $$$\sum (2 \cdot a_i) = 2 \cdot \sum a_i$$$, что нам и нужно.
Для вычисления ближайшего простого достаточно предподсчитать решето Эратосфена и сделать на нем один обратный проход либо искать бинпоиском по отсортированному массиву простых чисел, что, в зависимости от выбранного подхода, без учета предподсчета, даст асимптотику либо $$$O(n)$$$, либо $$$O(n \log n)$$$.
def INT(): return int(input())
def MAP(): return map(int, (input().split()))
def MAT(n): return [list(map(int, (input().split()))) for _ in range(n)]
MAX_A=100_000
prime=[1]*(MAX_A+100)
prime[0]=0
prime[1]=0
for i in range(2,int(MAX_A**0.5)+10):
    if prime[i]:
        for j in range(i*i,MAX_A+100,i):
            prime[j]=0
next_prime=[0]*(MAX_A+100)
p=-1
for i in range(len(prime)-1,0,-1):
    next_prime[i]=p
    if prime[i]:
        p=i
for _ in range(INT()):
    n=INT()
    a=list(MAP())
    b=[next_prime[el] for el in a]
    print(*b)
2284C2 - Омерзительно + GCD (версия с чекером)
Решите задачу C1.
Подумайте, в каких случаях нам точно хватит не более 2 операций.
Для начала разберем и тут же забудем про тривиальные случаи с $$$\mathrm{dist}(a, b) \lt 2$$$.
Теперь заметим, что, если отрезок $$$[a, b]$$$ содержит хотя бы одно простое, нам потребуется ровно $$$2$$$ операции. Чтобы увидеть это, рассмотрим в качестве промежуточного числа наибольшее среди этих простых $$$p$$$. Число $$$b$$$ не может делить $$$p$$$, поскольку мы знаем, что оно строго его больше (иначе бы мы смогли попасть из $$$a$$$ в $$$b$$$ за один шаг), но при этом, если бы оно было равно хотя бы $$$2p$$$, по постулату Бертрана в отрезке $$$[p+1, b]$$$ нашлось бы простое $$$q$$$, большее $$$p$$$, что невозможно, так как мы выбрали максимальное среди всех простых на отрезке. Значит, поскольку $$$p$$$ взаимнопросто и с $$$a$$$, и с $$$b$$$, мы можем перейти сначала в него, а затем сразу в $$$b$$$.
Осталось покрыть все случаи, когда $$$\gcd(a, b) \gt 1$$$ и отрезок $$$[a, b]$$$ не содержит простых. Поскольку $$$a \le 10^5$$$, мы можем сделать это, просто перебрав все такие пары, отсортированные по возрастанию длины, и построив на них тривиальную динамику. Это зайдет по времени, поскольку среднее расстояние между простыми числами, не превышающими $$$n$$$, равно примерно $$$\log(n)$$$, и сами простые распределены достаточно равномерно, поэтому общая асимптотика предподсчета будет примерно $$$O(m \log^2 m)$$$, где $$$m \le 10^5$$$.
Таким образом, мы получаем решение, похожее на решение $$$\mathrm{C1}$$$: разбираем за $$$O(1)$$$ тривиальные случаи, затем с помощью решета Эратосфена проверяем, верно ли, что наибольшее простое, меньшее $$$b$$$, больше $$$a$$$. Если больше, то строим ответ в $$$2$$$ операции, иначе берем его из нашего дп.
Ну или вы можете просто угадать, что $$$\mathrm{dist}(a, b) \le 2$$$ при $$$b - a \ge \text{small const}$$$, но это неинтересно. На самом деле эта задача в общем виде является открытой проблемой, и, судя по всему, $$$\mathrm{dist}(a, b)$$$ никогда не превышает $$$3$$$. Если у вас появится содержательное доказательство обратного, можете поделиться им в комментариях.
def INT(): return int(input())
def MAP(): return map(int, (input().split()))
def MAT(n): return [list(map(int, (input().split()))) for _ in range(n)]
from collections import defaultdict
from bisect import bisect_left
from math import gcd

MAXN=100021
sieve=[1]*(MAXN+1)

for p in range(2,int(MAXN**0.5)+2):
    if sieve[p]:
        sieve[p*p::p]=[0]*len(sieve[p*p::p])

np=[-1]*MAXN
loc=100019
for i in range(MAXN):
    if sieve[i]:loc=i
    np[i]=loc

primes=[i for i in range(2,MAXN+1) if sieve[i]]
pp=[]

for p1,p2 in zip(primes,primes[1:]):
    for x in range(p1+1,p2-1):
        for y in range(x+1,p2):
            pp.append((x,y))

pp.sort(key=lambda p:p[1]-p[0])

dp0=defaultdict(dict)
dp=defaultdict(dict)

for x,y in pp:
    if gcd(x,y)==1:
        dp0[x][y],dp[x][y]=1,y
        continue
    best=100
    ne=-1
    for z in range(x+1,y):
        dist=dp0[x][z]+dp0[z][y]
        if dist<best:
            best,ne=dist,dp[x][z]
            if dist==2:
                break
    dp0[x][y],dp[x][y]=best,ne

def path(x,y):
    rs=[]
    cur=x
    while cur!=y:
        cur=dp[cur][y]
        rs.append(cur)
    return rs

for _ in range(INT()):
    x,y=MAP()
    if x==y:
        print(0)
        print()
        continue
    if gcd(x,y)==1:
        print(1)
        print(y-x)
        continue
    p=np[min(y,MAXN-1)]
    if gcd(p,y)>1:p=np[p-1]
    if x<p:
        print(2)
        print(p-x,y-p)
    else:
        rs=[x]+path(x,y)
        print(len(rs)-1)
        for i in range(len(rs)-1):
            print(rs[i+1]-rs[i],end=' ')
        print()
2284D - Теорема о двух кружках
Придумайте, как передать $$$n - 2$$$ бита.
Кажется полезным попробовать изучить, как применяемая ПАБ операция влияет на графы с простой структурой.
В ожидаемом решении переданный граф почти всегда является деревом.
Если внимательно присмотреться, нетрудно заметить, что если переданный ЛКП граф является двудольным, ПАБ своими операциями не сможет повлиять на множества одноцветных вершин в двудольной раскраске, поскольку любой выбранный им простой путь всегда соединяет вершины разных цветов, а значит, любое добавленное им ребро не нарушит исходное разбиение на доли, при этом сохраняя связность графа.
Отсюда сразу же появляется следующая идея решения: построим двудольный граф, в котором вершина $$$i$$$ будет кодировать бит $$$s_{i - 1}$$$ в зависимости от того, получит ли она тот же цвет в двудольной раскраске, что и вершина $$$1$$$. В качестве двудольного графа проще всего использовать дерево.
Однако у нас остается один случай, когда строка состоит только из единиц, ведь в таком случае мы должны построить связный двудольный граф, в котором все вершины должны быть покрашены в один цвет, что, очевидно, невозможно. Чтобы закодировать его, передадим ПАБ любой граф, не являющийся двудольным, например, нам подойдет дерево, в котором мы замкнули цикл $$$1$$$—$$$2$$$—$$$3$$$. Остается доказать, что ПАБ не сможет сделать такой граф двудольным за любое число операций.
Предположим от противного, что за одну операцию ПАБ смог получить из недвудольного графа $$$G$$$ двудольный граф $$$G'$$$.
Тогда в графе $$$G'$$$ существует правильная $$$2$$$-раскраска $$$\chi$$$. Так как в $$$G'$$$ присутствует добавленное ребро $$$(v_1, v_{2k})$$$, его концы обязаны иметь разные цвета, то есть $$$\chi(v_1) \neq \chi(v_{2k})$$$.
Остальная часть пути без удаленного ребра $$$(v_i, v_{i+1})$$$ целиком содержится в $$$G'$$$ и состоит из $$$(2k - 1) - 1 = 2k - 2$$$ ребер. Поскольку ребер четное число, а цвета вдоль них строго чередуются, общее число смен цвета четно. С учетом того, что $$$\chi(v_1) \neq \chi(v_{2k})$$$, концы удаленного ребра также обязаны иметь разные цвета.
Следовательно, ребро $$$(v_i, v_{i+1})$$$ не нарушало раскраску $$$\chi$$$, а значит $$$\chi$$$ являлась правильной $$$2$$$-раскраской и для исходного графа $$$G$$$. Противоречие.
Докажите, что $$$n-1$$$ бит является точной верхней границей количества информации, которую может передать ЛКП.
def INT(): return int(input())
def MAP(): return map(int, (input().split()))
def MAT(n): return [list(map(int, (input().split()))) for _ in range(n)]
def dfs(g):
    l=[1]
    vis=[0]*(n+1)
    dd=[1]*(n+1)
    d=1
    while l:
        cur=l.pop()
        if vis[cur]:d-=1
        else:
            vis[cur]=1
            dd[cur]=d%2
            d+=1
            l.append(cur)
            for nei in g[cur]:
                if not vis[nei]:
                    l.append(nei)
    return dd[2:]
ty=input()
for _ in range(INT()):
    if ty=='first':
        n=INT()
        s=input()
        if '0' not in s:
            print(n)
            for i in range(n-1):
                print(1,2+i)
            print(2,3)
            continue
        print(n-1)
        lst=s.index('0')+2
        for i in range(2,n+1):
            if s[i-2]=='0':
                print(1,i)
            else:print(lst,i)
    if ty=='second':
        n,m=MAP()
        g=[[] for i in range(n+1)]
        for i in range(m):
            u,v=MAP()
            g[u].append(v)
            g[v].append(u)
        if m==n:
            print('1'*(n-1))
            continue
        print(*dfs(g),sep='')
2284E - Мой разум гибнет
Граф $$$G$$$ не обязательно связен.
Какое максимальное количество уникальных отдельных компонент могут связывать секретные ребра?
[ SYS_MSG: ANALYSIS PROTOCOL INITIATED ]
Для начала заметим, что оба загаданных ребра обязаны соединять одну и ту же пару компонент связности графа $$$G$$$. Действительно, зафиксируем двудольную раскраску каждой компоненты. Добавление ребра между двумя разными компонентами всегда сохраняет двудольность, поскольку мы можем инвертировать раскраску одной из них. При этом каждое добавленное ребро задает требование к относительной инверсии раскрасок двух компонент. Если бы загаданные ребра соединяли разные пары компонент, то мы могли бы независимо выполнить все эти требования, и граф остался бы двудольным. Не соединять компоненты ребра также не могут, поскольку в таком случае они обязаны были бы соединять вершины разных цветов, и граф $$$G'$$$ также остался бы двудольным, а значит, оба ребра соединяют одну и ту же пару компонент.
Теперь пронумеруем вершины, последовательно обходя компоненты связности, а внутри каждой компоненты используя $$$\text{BFS}$$$. Важное свойство такой нумерации заключается в том, что любой префикс вершин внутри одной компоненты образует связный граф: у каждой вершины, кроме первой, уже присутствует ее родитель в $$$\text{BFS}$$$.
Первым бинарным поиском найдем вершину $$$u$$$, являющуюся концом одного из загаданных ребер. Для этого будем спрашивать, является ли двудольным подграф, состоящий из первых $$$k$$$ вершин. Он будет двудольным до тех пор, пока в него не попадут все концы обоих загаданных ребер, после чего в нем появится нечетный цикл, поэтому для ее поиска мы можем использовать бинарный поиск, потратив не более $$$\log 2000 = 11$$$ запросов.
Перенумеруем вершины еще раз, поставив первой компоненту, содержащую $$$u$$$, и запустив $$$\text{BFS}$$$ уже из нее, после чего аналогичным бинарным поиском найдем одну из вершин $$$v$$$ во второй компоненте, также являющуюся концом одного из загаданных ребер.
Теперь проверим запросом второго типа, является ли ребро $$$u$$$—$$$v$$$ одним из загаданных. Если да, то мы уже победили. В противном случае воспользуемся тем, что $$$u$$$ и $$$v$$$ не могут быть концами одного и того же ребра, а значит загаданные ребра не имеют общих концов, и в каждой из двух компонент есть ровно по два конца загаданных ребер. Один из них в каждой компоненте мы уже нашли.
Осталось найти второй конец в одной из компонент. Для этого выберем одну из двух компонент, перенумеруем ее вершины с помощью $$$\text{BFS}$$$ из ее найденной вершины и снова запустим бинарный поиск. На этот раз в каждом запросе будем рассматривать префикс выбранной компоненты вместе со всеми вершинами другой компоненты.
Последний бинарный поиск может быть оптимизирован до не более чем $$$10$$$ запросов, если для него мы выберем меньшую из двух компонент. Таким образом в худшем случае нам потребуется всего $$$11 + 11 + 1 + 10 = 33$$$ запроса.
> TASK COMPLETED. TERMINATING PROCESS.
#include <bits/stdc++.h>
using namespace std;

using ll = long long;
using pi = pair<int, int>;

bool query(vector<int>& v) {
    if (v.empty()) return true;

    cout << "? 1 " << v.size();
    for (auto i : v) cout << ' ' << i;
    cout << endl;

    int x;
    cin >> x;

    if (x == -1) exit(0);

    return x;
}

int bs(vector<int>& v, vector<int>& include) {
    int lo = 0;
    int hi = v.size();

    while (lo + 1 < hi) {
        int mid = (lo + hi) / 2;

        vector<int> ask = include;
        for (int i = 0; i < mid; i++) {
            ask.push_back(v[i]);
        }

        if (query(ask)) lo = mid;
        else hi = mid;
    }

    return v[lo];
}

void solve(void) {
    int n, m;
    cin >> n >> m;

    vector<vector<int>> adj(n + 1);

    for (int i = 0; i < m; i++) {
        int a, b;
        cin >> a >> b;

        adj[a].push_back(b);
        adj[b].push_back(a);
    }

    vector<int> comp(n + 1);
    vector<vector<int>> component;
    vector<int> dfs_order;

    {
        vector<bool> vis(n + 1);

        auto dfs = [&](auto&& self, int i) -> void {
            if (vis[i]) return;

            component.back().push_back(i);
            vis[i] = true;
            comp[i] = component.size();

            dfs_order.push_back(i);

            for (auto u : adj[i]) {
                self(self, u);
            }
        };

        for (int i = 1; i <= n; i++) {
            if (vis[i]) continue;

            component.emplace_back();
            dfs(dfs, i);
        }
    }

    vector<int> lol;
    int a = bs(dfs_order, lol);

    vector<int> out;

    for (auto i : dfs_order) {
        if (comp[i] != comp[a]) {
            out.push_back(i);
        }
    }

    vector<int> in;

    {
        vector<bool> vis(n + 1);

        auto dfs = [&](auto&& self, int i) -> void {
            if (vis[i]) return;

            vis[i] = true;
            in.push_back(i);

            for (auto u : adj[i]) {
                self(self, u);
            }
        };

        dfs(dfs, a);
    }

    int b = bs(in, out);
    int c = bs(out, in);

    cout << "? 2 " << a << ' ' << c << endl;

    int r;
    cin >> r;

    if (r) cout << "! " << a << ' ' << c << endl;
    else cout << "! " << b << ' ' << c << endl;
}

int main(void) {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int t;
    cin >> t;

    while (t--) solve();

    return 0;
}
2284F - Наступает, братва
Посмотрите на процесс изменений элементов множества как на последовательность операций с декой.
Для моделирования процесса поддерживайте деку изначальной длины $$$n$$$, в $$$i$$$ ячейке которой будет храниться средняя вероятность по всем надмножествам того, что на очередном шаге множество содержит элемент $$$i$$$.
Для эффективного пересчета статистик деки вы можете использовать какую-то известную структуру данных.
Решение скоро будет опубликовано.
#include <bits/stdc++.h>
using namespace std;

template <typename T>
T mod_inv_in_range(T a, T m) {
    T x = a, y = m;
    T vx = 1, vy = 0;

    while (x) {
        T k = y / x;
        y %= x;
        vy -= k * vx;

        swap(x, y);
        swap(vx, vy);
    }

    return vy < 0 ? m + vy : vy;
}

template <int MOD_>
struct modnum {
    static constexpr int MOD = MOD_;

private:
    int v;

public:
    modnum() : v(0) {}

    modnum(int64_t v_) : v(int(v_ % MOD)) {
        if (v < 0) v += MOD;
    }

    explicit operator int() const {
        return v;
    }

    friend ostream& operator<<(ostream& out, const modnum& n) {
        return out << int(n);
    }

    friend istream& operator>>(istream& in, modnum& n) {
        int64_t v_;
        in >> v_;
        n = modnum(v_);
        return in;
    }

    friend bool operator==(const modnum& a, const modnum& b) {
        return a.v == b.v;
    }

    friend bool operator!=(const modnum& a, const modnum& b) {
        return a.v != b.v;
    }

    modnum inv() const {
        modnum res;
        res.v = mod_inv_in_range(v, MOD);
        return res;
    }

    friend modnum inv(const modnum& m) {
        return m.inv();
    }

    modnum neg() const {
        modnum res;
        res.v = v ? MOD - v : 0;
        return res;
    }

    friend modnum neg(const modnum& m) {
        return m.neg();
    }

    modnum operator-() const {
        return neg();
    }

    modnum operator+() const {
        return modnum(*this);
    }

    modnum& operator++() {
        v++;
        if (v == MOD) v = 0;
        return *this;
    }

    modnum& operator--() {
        if (v == 0) v = MOD;
        v--;
        return *this;
    }

    modnum& operator+=(const modnum& o) {
        v -= MOD - o.v;
        v = (v < 0) ? v + MOD : v;
        return *this;
    }

    modnum& operator-=(const modnum& o) {
        v -= o.v;
        v = (v < 0) ? v + MOD : v;
        return *this;
    }

    modnum& operator*=(const modnum& o) {
        v = int(int64_t(v) * int64_t(o.v) % MOD);
        return *this;
    }

    modnum& operator/=(const modnum& o) {
        return *this *= o.inv();
    }

    friend modnum operator++(modnum& a, int) {
        modnum r = a;
        ++a;
        return r;
    }

    friend modnum operator--(modnum& a, int) {
        modnum r = a;
        --a;
        return r;
    }

    friend modnum operator+(const modnum& a, const modnum& b) {
        return modnum(a) += b;
    }

    friend modnum operator-(const modnum& a, const modnum& b) {
        return modnum(a) -= b;
    }

    friend modnum operator*(const modnum& a, const modnum& b) {
        return modnum(a) *= b;
    }

    friend modnum operator/(const modnum& a, const modnum& b) {
        return modnum(a) /= b;
    }
};

const int MOD = 1e9 + 7;
using mint = modnum<MOD>;

pair<mint, mint> merge(
    const pair<mint, mint>& a,
    const pair<mint, mint>& b
) {
    return make_pair(
        a.second * b.second - (a.second - a.first) * (b.second - b.first),
        a.second * b.second
    );
}

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(nullptr);

    int T;
    cin >> T;

    while (T--) {
        int n, m;
        string input;
        cin >> m >> input;

        mint correction = 0, ways = 1;

        for (int i = m - 1; i >= 0; i--) {
            correction += ways;
            if (input[i] == '0') ways *= 2;
        }

        rotate(input.begin(), input.begin() + 1, input.end());
        n = count(input.begin(), input.end(), '1');

        deque<pair<mint, mint>> a(m, make_pair(1, 2));

        for (int x = 0; x < m; x++) {
            if (input[x] == '1') {
                a[(x + 1) % m] = make_pair(1, 1);
            }
        }

        mint curprod = 1, curterm = 0, prody = 1;

        for (auto& [x, y] : a) {
            curprod *= x;
            curterm = curterm * y + curprod;
            prody *= y;
        }

        mint ans = 0;

        for (int i = 0; i < m; i++) {
            ans += curterm;

            if (i == m - 1) break;

            curprod /= a[0].first;
            curterm /= a[0].first;

            a[0] = merge(a.back(), a[0]);

            curprod *= a[0].first;
            curterm *= a[0].first;
            curterm -= curprod;

            curterm /= a.back().second;
            curprod /= a.back().first;

            a.pop_back();

            curterm += prody - curprod;
            curterm *= a.back().first / a.back().second;

            pair<mint, mint> tmp = a.back();
            a.pop_back();
            a.push_front(tmp);
        }

        cout << ans - correction << '\n';
    }

    return 0;
}


Thankfully, I successfully guessed the solution of both A2 and C2 last minute to save my rating.
Problems are really good but abit more on the harder side especially A2 imo
I was not sure of the proof of even A1, because it generally doesn't happen that you have to think of a proof in the first problem, so I worked on the feeling that right triangle feels best
A1 was fine i started contest pretty late . for me A2>>>C1>B . i knew i could do A2 with dp but i was tying to avoid it
dp would be too slow i think
I also thought of subset sum like dp for A2 .. but I guess it will not fit in the time limit.
well it was A2 for a reason for sure it should be something silly should be in head ig
here is a dumbman's editorial for A1 who dont dunno trigonometry.
alr, area of triangle is 1/2 breadth*height=x/2 so u gotta maximize x to get maximum area
breadth+height=y where y is a constant, lets test it for some values of y, let y be 9 1,8 -> 8 2,7 ->14 3,6 ->18 4,5 ->20
so u noticed something? the lesser the |breadth-height| the more the value of x
soooooo just let breadth=y//2+y%2 and height=y//2
but our problem doesnt have b,h !, it have a b c instead, well just let a be height, b be 0, c be breadth
we have n number of operation so y=n
b+c=y//2+y%2,h=y//2 maximum area = n//2 * (n//2 + n%2)
here is editorial for c1 cuz i solved it hehe
to make all number co prime to each other, find smallest prime number greater than after array[i] then just x=smallest prime number greater than array[i]-array[i]
here is editorial for B
so what if we just sort the array, and swap reverse every value from array[k-1] to array[-1] , well then we will get only k pleasent values problem solved!
i mean suppose arr is [1,2,3,4,5,6,7,8] then for k=3 we will output [1,2,8,7,6,5,4,3]
simple as fuck solution to A2
this A2 was easy af lol i mean easier than A1 maybe haha, its legit just keeping powers as close as possible
lemme solve D too, then ill try to write my sol in layman's language