

Спасибо всем за участие!
Точка $$$(x_0 - R, y_0)$$$ всегда лежит на окружности, потому что $$$(x_0 - (x_0 - R))^2 + (y_0 - y_0) ^2 = R^2$$$ истинно для всех $$$R$$$, ведь, раскрывая скобки, получаем $$$R^2 = R^2$$$.
#include <bits/stdc++.h>
using namespace std;
#define all(x) x.begin(), x.end()

signed main() {
    int tt;
    cin >> tt;
    while (tt --> 0) {
        int x, y, R;
        cin >> x >> y >> R;
        cout << x - R << " " << y << endl;
    }
}
Заведём булевый массив $$$\text{used}$$$ и будем отмечать в нём, какие документы были напечатаны. При операции типа 3 просто отметим $$$\text{used}_i = 1$$$. Операции 1 и 2 на самом деле обозначают операции push и pop у стека. Заведём также stack $$$\operatorname{memory}$$$, при операции первого типа будем делать push номера документа, при операции второго типа будем делать pop и отмечать $$$\text{used}[\operatorname{memory}.\text{top}()] = 1$$$. Также не забываем разобрать случай, когда в $$$\operatorname{memory}$$$ ничего не лежит. В конце просмотрим массив $$$\text{used}$$$ и выпишем все неотмеченные элементы. Время работы $$$O(n)$$$.
#include <bits/stdc++.h>
using namespace std;
#define all(x) x.begin(), x.end()

int main() {
    int t;
    cin >> t;
    while (t --> 0) {
        int n;
        string s;
        cin >> n >> s;
        vector<int> stack_;
        vector<bool> used(n);
        for (int i = 0; i < n; ++i) {
            if (s[i] == '1') {
                stack_.push_back(i);
            } else if (s[i] == '2') {
                if (stack_.empty()) {
                    used[i] = true;
                } else {
                    used[stack_.back()] = true;
                    stack_.pop_back();
                }
            } else {
                used[i] = true;
            }
        }
        vector<int> res;
        for (int i = 0; i < n; ++i) {
            if (!used[i]) {
                res.push_back(i + 1);
            }
        }
        cout << res.size() << '\n';
        for (auto &x : res) {
            cout << x << " ";
        }
        cout << '\n';
    }
    return 0;
}
Пусть $$$f(x) = a_x + a_{x+2} - a_{x+4}$$$ — значение трезвучия с началом $$$x$$$. Два трезвучия $$$x \lt y$$$ пересекаются, только если $$$y - x = 2$$$ или $$$y - x = 4$$$. Значит, ответ — это число пар $$$x \lt y$$$ с $$$f(x) = f(y)$$$ минус пары с таким же равенством, у которых $$$y - x \in {2, 4}$$$.
Идём по $$$y$$$ слева направо и храним в словаре, сколько раз встречалось каждое значение $$$f$$$. Прибавляем к ответу количество уже встреченных $$$f(y)$$$. Потом отдельно вычитаем $$$1$$$, если $$$f(y - 2) = f(y)$$$, и ещё $$$1$$$, если $$$f(y - 4) = f(y)$$$: эти пары только что засчитались, но они пересекаются. Ответ может достигать $$$\sim 2\cdot10^{10}$$$, поэтому нужен 64-битный тип (long long).
Время работы $$$O(n \log n)$$$ из-за использования словаря.
#include <bits/stdc++.h>
using namespace std;
#define int long long
#define all(x) x.begin(), x.end()

signed main() {
    int tt;
    cin >> tt;
    while (tt--> 0) {
        int n;
        cin >> n;
        vector<int> a(n);
        vector<int> arr;
        map<int, int> mp;
        int ans = 0;
        for (int i = 0; i < n - 4; i++) {
            int cur = a[i] + a[i + 2] - a[i + 4];
            ans += mp[cur];
            if (i >= 2 && arr[i - 2] == cur) ans--;
            if (i >= 4 && arr[i - 4] == cur) ans--;
            mp[cur]++;
            arr.push_back(cur);
        }
        cout << ans << endl;
    }
}
У данной задачи формально 3 случая:
- $$$a_i = b_i = c_i$$$ никуда не движется, ответ не станет больше чем $$$a_i + b_i + c_i$$$
- $$$a_i \le b_i \le c_i$$$, чтобы выйти из данной позиции, придется использовать ходы с вычитанием; подробнее дальше
- $$$a_i \gt b_i \ \lor \ a_i \gt c_i \ \lor \ b_i \gt c_i$$$. Можно просто прибавлять бесконечно, потому что меняется третий элемент, остальные 2 не меняются
Что делать в позиции $$$a_i \le b_i \le c_i$$$: Нам нужно сделать либо $$$c_i = b_i - 1$$$, либо $$$b_i = a_i - 1$$$, после чего можно увеличивать сумму до бесконечности. Поэтому можно записать стоимость поднять $$$S = a_i + b_i + c_i$$$ до суммы $$$m$$$ в этом случае как:
где $$$e = \min(b - a, c - b) + 1$$$
Это монотонная функция, поэтому можно сделать бинпоиск по ответу, не забыв про все тройки $$$a_i = b_i = c_i$$$. Время работы $$$O(n \log k)$$$
#include <bits/stdc++.h>
using namespace std;
#define int long long

signed main() {
    int t;
    cin >> t;
    while (t --> 0) {
        int n;
        int k;
        cin >> n >> k;

        vector<int> S(n), E(n);
        vector<int> dead(n);

        const int BIG = numeric_limits<int>::max() / 4;
        int lo = BIG, cap = BIG;

        vector<int> A(n), B(n), C(n);
        for (int i = 0; i < n; i++) cin >> A[i] >> B[i] >> C[i];

        for (int i = 0; i < n; i++) {
            int a = A[i], b = B[i], c = C[i];
            S[i] = a + b + c;
            dead[i] = (a == b && b == c);
            E[i] = (a <= b && b <= c) ? min(b - a, c - b) + 1 : 0LL;
            lo = min(lo, S[i]);
            if (dead[i]) cap = min(cap, S[i]);
        }

        int hi = min(cap, lo + k) + 1;

        auto is_ok = [&](int m){
            int total = 0;
            for (int i = 0; i < n; i++) {
                if (S[i] >= m) continue;
                if (dead[i]) return 0;
                total += (m - S[i]) + 2 * E[i];
                if (total > k) return 0;
            }
            return 1;
        };

        while (hi - lo > 1) {
            int mid = (hi + lo) / 2;
            if (is_ok(mid)) lo = mid;
            else hi = mid;
        }
        cout << lo << '\n';
    }
}
Дороги соединяют только здания с разных сторон, поэтому маршрут чередует стороны, проходит ровно $$$2n - 1$$$ дорогу и имеет длину $$$2n - 1 + (\text{число дорог между зданиями одной компании})$$$. Поймём, какие маршруты вообще возможны. Пусть K1o0n стоит в $$$a_k$$$, а все столбцы левее уже пройдены. Если он идёт в $$$b_k$$$, то оттуда остаётся единственный ход в $$$a_{k+1}$$$, и мы попадаем в ту же ситуацию со столбца $$$k+1$$$. Если же он идёт по диагонали в $$$b_{k+1}$$$, то у $$$b_k$$$ остаётся единственный свободный сосед $$$a_{k+1}$$$, и $$$b_k$$$ обязано стать концом маршрута. Дальше всё вынуждено: зигзагом $$$a_k \to b_{k+1} \to a_{k+2} \to \ldots$$$ до конца, по дороге $$$a_n - b_n$$$ на другую сторону и обратно вторым зигзагом до $$$b_k$$$. Значит, маршрут задаётся одним числом $$$k$$$: сначала «змейкой» $$$a_1 \to b_1 \to a_2 \to \ldots \to b_{k-1} \to a_k$$$, а потом петля до конца и обратно.
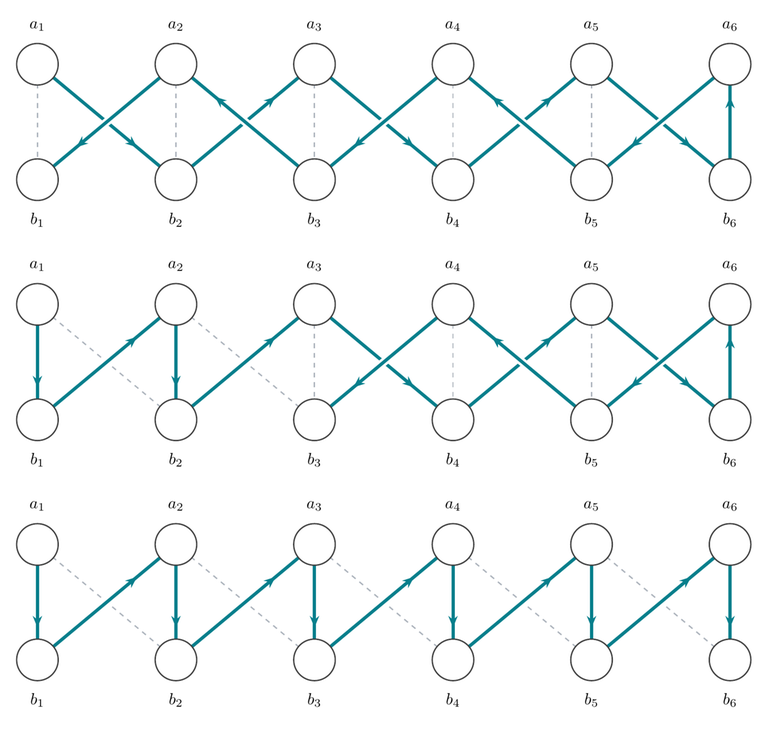
Всего вариантов $$$n$$$. Начальная длина считается для $$$k = 1$$$ (два зигзага плюс дорога $$$a_n - b_n$$$). Переход от $$$k$$$ к $$$k + 1$$$ меняет одну дорогу: $$$a_k - b_{k+1}$$$ на $$$a_k - b_k$$$. Поэтому длину каждого следующего маршрута получаем из предыдущего за $$$O(1)$$$ и берём максимум, итого $$$O(n)$$$.
#include <bits/stdc++.h>
using namespace std;

signed main() {
    auto f = [](int x, int y) {
        return 1 + (x == y);
    };
    int tt;
    cin >> tt;
    while (tt --> 0) {
        int n;
        cin >> n;

        vector<int> a(n), b(n);
        for (auto &x : a) cin >> x;
        for (auto &x : b)

        int current = f(a.back(), b.back());
        for (int i = 0; i + 1 < n; i++) {
            current += f(a[i + 1], b[i]);
            current += f(a[i], b[i + 1]);
        }

        int answer = current;

        for (int i = 0; i + 1 < n; i++) {
            current -= f(a[i], b[i + 1]);
            current += f(a[i], b[i]);
            answer = max(answer, current);
        }

        cout << answer << '\n';
    }
}
Поймём, когда число $$$x$$$ имеет нечётное количество делителей. Для этого посмотрим на его разложение на простые множители $$$x = p_1^{d_1} p_2^{d_2} \ldots p_k^{d_k}$$$. Тогда количество делителей равно $$$\prod (d_i + 1)$$$, чтобы оно было нечётным, нужно, чтобы каждый множитель был нечётным, а значит каждая степень $$$d_i$$$ является чётной. $$$F(i, j)$$$ — произведение двух величин, и все простые в него входят в чётной степени тогда и только тогда, когда для двух множителей множества простых, входящих в нечётную степень, совпадают. Для каждого префикса будем хранить набор простых, входящих в произведение в нечётной степени.
Заметим, что хранить все такие наборы не обязательно. Если в наборе больше $$$7$$$ простых, их произведение гарантированно больше любого $$$a_i$$$, а одна ложка должна была бы содержать их все сразу. Значит, такой префикс не превратить в квадрат ни одним $$$a_i$$$. Поэтому поддерживаем словарь только подходящих наборов, а не всех. Тогда ответ — это сумма по всем $$$a_i$$$ количества префиксов, у которых набор простых нечётной степени совпадает с набором самого $$$a_i$$$. Время работы $$$O(n \log (7n))$$$, константа $$$7$$$ здесь обозначает максимальное количество простых делителей у числа до $$$10^6$$$.
#include <bits/stdc++.h>
using namespace std;
#define all(x) x.begin(), x.end()

signed main() {
    vector<int> primes;
    vector<bool> is_prime(32000 + 1, 1);
    is_prime[0] = is_prime[1] = 0;
    for (int i = 2; i <= 32000; i++) {
        if (is_prime[i]) {
            primes.push_back(i);
            for (int j = i * i; j <= 32000; j += i) {
                is_prime[j] = 0;
            }
        }
    }

    int t;
    cin >> t;
    while (t --> 0) {
        int n;
        cin >> n;
        vector<int> a(n);
        for (auto &x : a) cin >> x;

        vector<vector<int>> ker(n);
        for (int i = 0; i < n; i++) {
            int x = a[i];
            for (int j = 0; j < primes.size() && primes[j] * primes[j] <= x; j++) {
                if (x % primes[j] == 0) {
                    int e = 0;
                    while (x % primes[j] == 0) { x /= primes[j]; e++; }
                    if (e & 1) ker[i].push_back(primes[j]);
                }
            }
            if (x > 1) ker[i].push_back(x);
        }

        map<vector<int>, int> mp;
        set<int> odd;
        for (int i = 0; i < n; i++) {
            for (int p : ker[i])
                if (!odd.insert(p).second) odd.erase(p);
            if (odd.size() <= 7)
                mp[vector<int>(all(odd))]++;
        }

        long long ans = 0;
        for (int i = 0; i < n; i++) {
            auto it = mp.find(ker[i]);
            if (it != mp.end()) ans += it->second;
        }
        cout << ans << "\n";
    }
}
2275G - Медяное расточительство
Сначала поймём, что выгоднее оставить. Пусть в итоге из старых кабелей осталось $$$r$$$ штук, и они образуют лес. Тогда компонент $$$n - r$$$, и бригаде придётся протянуть $$$n - r - 1$$$ новых кабелей. Всё, что не оставили, сдаём. Значит, при фиксированном $$$r$$$ выгоднее всего оставить самые дешёвые $$$r$$$ кабелей, которые ещё образуют лес. Это ровно первые $$$r$$$ рёбер, которые возьмёт алгоритм Краскала, то есть $$$r$$$ самых дешёвых рёбер минимального остовного леса.
Отсюда решение. Построим для каждой компоненты связности минимальное остовное дерево и сразу продадим все рёбра, которые в них не входят: держать их нет смысла ни при каком $$$x$$$. Если компонент $$$c$$$, то на их соединение нужно $$$c - 1$$$ новых кабелей, и это стоит $$$x + 2x + \ldots + (c-1)x = x \cdot \frac{c(c-1)}{2}$$$.
Дальше можно продавать и рёбра самого остова, начиная с самых дорогих. Каждое снятое ребро разбивает компоненту на две, и за это приходится протянуть ещё один кабель: первый такой обойдётся в $$$x \cdot c$$$, второй в $$$x \cdot (c + 1)$$$ и так далее. Пусть рёбра остова отсортированы по убыванию: $$$e_1 \ge e_2 \ge \ldots$$$. Тогда снимать $$$i$$$-е ребро выгодно ровно тогда, когда $$$e_i \gt x \cdot (c + i - 1)$$$. Левая часть убывает, правая растёт, поэтому выгодные рёбра образуют префикс, и его длину для каждого сценария находим бинпоиском. Префиксные суммы $$$e_i$$$ дают ответ за $$$O(1)$$$.
Итого $$$O(m \log m)$$$ на Краскала и $$$O(\log n)$$$ на сценарий. Прибыль может быть отрицательной, если компонент много, а траты на монтаж доходят до $$$5 \cdot 10^8 \cdot \frac{10^5 \cdot (10^5 - 1)}{2} \approx 2.5 \cdot 10^{18}$$$, так что нужен 64-битный тип.
#include <bits/stdc++.h>
using namespace std;
#define int long long
#define all(x) x.begin(), x.end()

struct Dsu {
    vector<int> p, rank_;
    explicit Dsu(int n) : p(n), rank_(n, 0) { iota(p.begin(), p.end(), 0); }
    int find(int x) {
        while (p[x] != x) x = p[x] = p[p[x]];
        return x;
    }
    bool unite(int a, int b) {
        a = find(a); b = find(b);
        if (a == b) return false;
        if (rank_[a] < rank_[b]) swap(a, b);
        p[b] = a;
        if (rank_[a] == rank_[b]) ++rank_[a];
        return true;
    }
};

signed main() {
    int t;
    cin >> t;
    while (t --> 0) {
        int n, m, q;
        cin >> n >> m >> q;
        vector<array<int, 3>> edges(m); // {d, u, v}
        int total = 0;
        for (int i = 0; i < m; i++) {
            int u, v, d;
            cin >> u >> v >> d;
            edges[i] = {d, u - 1, v - 1};
            total += d;
        }
        sort(edges.begin(), edges.end());

        Dsu dsu(n);
        vector<int> w;
        w.reserve(min(m, n - 1));
        for (auto &e : edges)
            if (dsu.unite(e[1], e[2])) w.push_back(e[0]);
        int top = w.size();
        vector<int> pref(top + 1, 0);
        for (int i = 0; i < top; i++) pref[i + 1] = pref[i] + w[i];

        for (int i = 0; i < q; i++) {
            int x;
            cin >> x;
            int lo = 0, hi = top;
            while (lo < hi) {
                int mid = lo + (hi - lo) / 2;
                if (w[mid] - x * (n - mid - 1) >= 0) hi = mid;
                else lo = mid + 1;
            }
            int k = n - lo - 1;
            int cost = pref[lo] + x * (k * (k + 1) / 2);
            cout << total - cost << " ";
        }
        cout << endl;
    }
}
2275H - Задача для разминки бровей
Для подматрицы $$$[lx, ly, rx, ry]$$$ распишем сумму $$$S^2$$$ как
Поменяем порядок суммирования: будем выбирать пару ячеек $$$(i,j)$$$ и $$$(x,y)$$$ и рассмотрим вклад этой пары в общую сумму. Он равен
Так как нас интересует только чётность показателя, это выражение равно
Сгруппируем множители:
Заметим, что нам важна только чётность минимума и максимума номеров строк и столбцов. Переписывая выражение, получаем
Посчитаем сумму по парам различных ячеек $$$(x,y) \lt (i,j)$$$, где пары сравниваются лексикографически. Их вклад домножим на $$$2$$$, после чего отдельно прибавим вклад пар из одинаковых ячеек:
Вклад пар различных ячеек разобьём ещё на два типа: $$$i=x$$$ и $$$x \lt i$$$.
Ячейки из одной строки.
Первый вклад считаем отдельно для каждой строки. Будем идти по строке слева направо, поддерживать сумму элементов на чётных столбцах и прибавлять эту сумму, домноженную на $$$a_{i,j}$$$, если $$$(n-i)\equiv_2 1$$$.
Ячейки из разных строк.
Второй вклад считаем проходом по строкам от меньших номеров к большим. Для элемента $$$(i,j)$$$ надо отдельно рассмотреть элементы предыдущих строк, у которых номер столбца больше $$$j$$$, и элементы, у которых он не больше $$$j$$$. В зависимости от этого сравнения на $$$j$$$ и $$$y$$$ накладываются разные условия по чётности.
Будем поддерживать префиксные и суффиксные суммы по ячейкам со столбцами нужной чётности во всех предыдущих строках. После обработки очередной строки посчитаем такие префиксные и суффиксные суммы для неё и прибавим их к уже накопленным.
Итоговая сложность — $$$O(nm)$$$ по времени.
Credits: Noobish_Monk
#include <bits/stdc++.h>

using namespace std;

using ll = long long;
using pii = pair<int, int>;

template <uint32_t MOD>
struct ModularInt {
    int x = 0;

    ModularInt() {}

    ModularInt(int x) : x(x < 0 ? x + MOD : x % MOD) {}

    ModularInt(const ModularInt &other) : x(other.x) {}

    ModularInt operator+=(const ModularInt &other) {
        x += other.x;
        if (x >= MOD)
            x -= MOD;
        return *this;
    }

    ModularInt operator-=(const ModularInt &other) {
        x -= other.x;
        if (x < 0)
            x += MOD;
        return *this;
    }

    ModularInt operator*=(const ModularInt &other) {
        x = ((ll)x * other.x) % MOD;
        return *this;
    }

    ModularInt power(ll pw) const {
        ModularInt a(*this);
        ModularInt b = 1;
        for (; pw; pw >>= 1, a *= a)
            if (pw & 1)
                b *= a;
        return b;
    }

    ModularInt inv() const {
        return power(MOD - 2);
    }

    ModularInt operator/=(const ModularInt &other) {
        x = ((ll)x * other.inv().x) % MOD;
        return *this;
    }

    bool operator==(const ModularInt &other) {
        return x == other.x;
    }

    bool operator!=(const ModularInt &other) {
        return x != other.x;
    }

    friend ModularInt operator+(const ModularInt &a, const ModularInt &b) {
        return ModularInt(a) += b;
    }

    friend ModularInt operator-(const ModularInt &a, const ModularInt &b) {
        return ModularInt(a) -= b;
    }

    friend ModularInt operator*(const ModularInt &a, const ModularInt &b) {
        return ModularInt(a) *= b;
    }

    friend ModularInt operator/(const ModularInt &a, const ModularInt &b) {
        return ModularInt(a) /= b;
    }

    friend istream& operator>>(istream& in, ModularInt& other) {
        int x;
        in >> x;
        if (x < 0)
            x += MOD;
        x %= MOD;
        other = x;
        return in;
    }

    friend ostream& operator<<(ostream& out, const ModularInt& other) {
        return out << other.x;
    }
};

const int mod = 1e9 + 7;
using mint = ModularInt<mod>;

mint calc_row(const vector<mint> &a) {
    int n = a.size();
    mint ans = 0;
    mint sum = 0;
    for (int i = 0; i < n; i++) {
        if ((n - i) % 2 == 1)
            ans += sum * a[i];
        if (i % 2 == 0)
            sum += a[i];
    }
    return ans;
}

inline void solve() {
    int n, m;
    cin >> n >> m;
    vector a(n, vector<mint>(m));
    for (int i = 0; i < n; i++)
        for (int j = 0; j < m; j++)
            cin >> a[i][j];
    mint ans = 0;
    int sgn = 1;
    if (n % 2 == 1)
        sgn *= -1;
    if (m % 2 == 1)
        sgn *= -1;
    for (int i = 0; i < n; i++)
        if (i % 2 == 0 && (n - i) % 2 == 1)
            ans += calc_row(a[i]);
    vector<mint> psum_min(m), psum_max(m), tmp(m);
    for (int i = 0; i < n; i++) {
        if ((n - i) % 2 == 1) {
            for (int j = 0; j < m - 1; j++)
                if (j % 2 == 0)
                    ans += a[i][j] * psum_max[j + 1];
            for (int j = 0; j < m; j++)
                if ((m - j) % 2 == 1)
                    ans += a[i][j] * psum_min[j];
        }
        if (i % 2 == 0) {
            for (int j = 0; j < m; j++)
                tmp[j] = j % 2 == 0 ? a[i][j] : 0;
            for (int j = 1; j < m; j++)
                tmp[j] += tmp[j - 1];
            for (int j = 0; j < m; j++)
                psum_min[j] += tmp[j];
            for (int j = 0; j < m; j++)
                tmp[j] = (m - j) % 2 == 1 ? a[i][j] : 0;
            for (int j = m - 2; j >= 0; j--)
                tmp[j] += tmp[j + 1];
            for (int j = 0; j < m; j++)
                psum_max[j] += tmp[j];
        }
    }
    ans *= 2;
    for (int i = 0; i < n; i++)
        for (int j = 0; j < m; j++)
            if (i % 2 == 0 && (n - i) % 2 == 1 && j % 2 == 0 && (m - j) % 2 == 1)
                ans += a[i][j] * a[i][j];
    ans *= sgn;
    cout << ans << '\n';
}

signed main() {
    cin.tie(nullptr)->sync_with_stdio(0);
    int tt = 1;
    cin >> tt;
    for (int test_id = 1; test_id <= tt; test_id++) {
        solve();
    }
}




K1o0n
Please pin announcement and editorial to the contest.
Done
Very nice contest, had lots of fun with the unique problem-setting style (haven't seen these types recently).
K1o0n really nice contest
Hot take but I think that D and E > F, as someone that solved D and F I think that the observation on F was easier than seeing the greedy on E and the impl on D