


Есть задача timus1590. Проще говоря надо найти кол-во различных подстрок в строке. Было бы интересно услышать решение быстрее, чем O(n*n), если оно существует =).


| № | Пользователь | Рейтинг |
|---|---|---|
| 1 | jiangly | 3810 |
| 2 | Benq | 3676 |
| 3 | Kevin114514 | 3655 |
| 4 | maroonrk | 3463 |
| 5 | strapple | 3390 |
| 6 | Um_nik | 3387 |
| 7 | tourist | 3384 |
| 8 | heuristica | 3322 |
| 9 | turmax | 3319 |
| 10 | jiangbowen | 3291 |
| Страны | Города | Организации | Всё → |
| № | Пользователь | Вклад |
|---|---|---|
| 1 | Qingyu | 155 |
| 2 | nik_exists | 150 |
| 2 | maspy | 150 |
| 4 | Um_nik | 144 |
| 5 | Errichto | 139 |
| 6 | adamant | 137 |
| 6 | AmShZ | 137 |
| 8 | BledDest | 132 |
| 8 | maroonrk | 132 |
| 10 | qwexd | 129 |


O(NlogN)
Можно решать за:
O(nlogn). Построим суффиксный массив, а вместе с ним — массив lcp, в котором будем обозначать длины наибольших общих префиксов соседних в массиве суффиксов. Тогда ответ будет таким: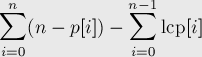
Подробнее о суффиксном массиве можно почитать на e-maxx.
O(n). Суффиксное дерево или суффиксный автомат. Можно заметить, что различные подстроки = различные пути в этих структурах. В суффиксном дереве (в "разжатом" виде) каждой подстроке будет соответствовать одна вершина. Значит, мы можем пройтись по всем рёбрам сжатого суффиксного дерева и добавлять к ответу last - first этого ребра. В суффиксном автомате можно явно посчитать кол-во путей динамикой с dfs'ом, а можно заметить, что суфф ссылки образуют суффиксное дерево перевёрнутой строки и сложить символы, которые они охватывают. Это тоже даст верный ответ.
P.S.
Строить суффиксный массив можно за O(N), искать lcp соседних суффиксов тоже — алгоритм Касаи. Почему O(NlogN)?
В принципе, можно. Но лично я не умею этого и не знаю, насколько это оправданно в плане отношения сложности написания алгоритмов и реального выигрыша во времени работы. Буду рад, если раскроешь тему.
На хабре неплохо написано.
Кстати, это, возможно, интересно. Суффиксное дерево можно построить за O(n), если иметь суффиксный массив и массив lcp. Правда, в оффлайне...
а правда, что dfs по суфдереву -> суфмас?
Ага.
Ну, если мы переходы в нём по алфавиту сортируем, а не рандомно храним.
на хабре написано про алгоритм 10-летней давности, который уже множество раз улучшили.
Сейчас есть два основных алгоритма построения суффиксного массива:
SA-IS и его улучшенная версия SACA-K, не требующая дополнительной памяти — O(n), на практике работают в 4-5 раз быстрее того, что описано у е-макса. страница автора
DivSufSort. . Во всех статьях пишут, что работает еще в 1.5-2 раза быстрее предыдущего алгоритма, но код поистине ужасен.
Они работают быстрее на практике или для worst-case? Это разные вещи.
для SACA-K в худшем случае длина сортируемой строки на каждой итерации уменьшается в 2 раза. Проверял на строках Фибоначчи, которые близки к этому (на каждой итерации получается переход от n-й к (n-2)-й строке Фибоначчи) — все равно работает в разы быстрее qsufsort.
про DivSufSort ничего не могу сказать, кроме того что написано здесь
double post
Delete