Div2A
Алёна счастлива, когда нет незавершенных слоев — то есть перед ней идеальный квадрат с нечетной длиной стороны. Поскольку порядок кусочков фиксирован, достаточно отслеживать общий текущий размер $$$s$$$ головоломки и после каждого дня проверять, является ли $$$s$$$ идеальным квадратом нечетного числа. Самый простой способ сделать это — создать дополнительный массив, содержащий $$$1^2, 3^2, 5^2, ..., 99^2$$$, и проверять после каждого дня, находится ли $$$s$$$ в этом массиве.
КодNT = int(input())
sqs = set()
k = 1
while k * k <= 100 * 1000:
sqs.add(k * k)
k += 2
for T in range(NT):
n = int(input())
a = list(map(int, input().split()))
answer = 0
cursum = 0
for t in a:
cursum += t
if cursum in sqs:
answer += 1
print(answer)
Div2B
Найдите символ, который появляется наименьшее количество раз — если есть ничья, возьмите более ранний символ в алфавите. Найдите символ, который появляется наибольшее количество раз — если есть ничья, возьмите более поздний символ в алфавите. Затем замените любой из символов с наименьшим количеством вхождений на символ с наибольшим количеством вхождений.
Код#include <bits/stdc++.h>
using namespace std;
int main() {
cin.tie(0)->sync_with_stdio(0);
int t;
cin >> t;
while (t--) {
int n;
cin >> n;
string s;
cin >> s;
vector<int> occ(26);
for (int i=0; i<n; i++)
occ[s[i] - 'a'] += 1;
pair<pair<int,char>,int> low, high;
low = high = {{occ[s[0] - 'a'], s[0]}, 0};
for (int i=1; i<n; i++) {
low = min(low, {{occ[s[i] - 'a'], s[i]}, i});
high = max(high, {{occ[s[i] - 'a'], s[i]}, i});
}
s[low.second] = s[high.second];
cout << s << "\n";
}
return 0;
}
Div2C
Мы можем разделить столбцы в матрице на три разные группы:
- столбцы, в которых мы проходим через верхнюю ячейку;
- столбцы, в которых мы проходим через нижнюю ячейку;
- столбцы, в которых мы проходим через обе ячейки.
В третьей группе должен быть ровно один столбец — это будет столбец, где мы переходим из верхней строки в нижнюю строку. Все остальные столбцы могут быть распределены между группами $$$1$$$ и $$$2$$$ так, как нам угодно: если мы хотим поместить столбец в первую группу, мы поставим его перед столбцом, в котором мы идем вниз; в противном случае мы поставим его после столбца, в котором мы идем вниз. Таким образом, мы можем получить любое распределение столбцов между первой и второй группой.
Теперь давайте рассмотрим вклад каждого столбца в ответ. Столбцы из первой группы добавляют $$$a_{1,i}$$$ к ответу, столбцы из второй группы добавляют $$$a_{2,i}$$$, столбец из третьей группы добавляет оба этих значения. Таким образом, мы можем перебрать индекс столбца, в котором мы идем вниз, взять $$$a_{1,i} + a_{2,i}$$$ для него, а для всех остальных взять $$$\max(a_{1,j}, a_{2,j})$$$. Это работает за $$$O(n^2)$$$, и в ограничениях задачи этого достаточно.
Но можно решить задачу быстрее — за $$$O(n)$$$. Для этого посчитаем сумму $$$\max(a_{1,j}, a_{2,j})$$$ по всем столбцам. Затем, если мы выберем $$$i$$$-й столбец как столбец, через который мы идем вниз, ответ будет равен этой сумме плюс $$$\min(a_{1,i}, a_{2,i})$$$, поскольку это будет единственный столбец, в котором мы посетим обе ячейки.
Кодfor _ in range(int(input())):
n = int(input())
a = []
for i in range(2):
a.append(list(map(int, input().split())))
best = [max(a[0][i], a[1][i]) for i in range(n)]
full = [a[0][i] + a[1][i] for i in range(n)]
sum_best = sum(best)
ans = -10 ** 19
for i in range(n):
ans = max(ans, sum_best + full[i] - best[i])
print(ans)
Div2D
Первая идея заключается в том, чтобы заметить, что каждый элемент перемещается назад не более одного раза. Действительно, если мы зафиксируем подмножество элементов, которые мы когда-либо перемещаем назад, мы можем выполнить операцию один раз для каждого из них в любом порядке, который нам нравится, и это станет их окончательным порядком с наименьшим возможным увеличением. Оптимальный порядок, конечно, это возрастающий порядок. Вопрос в том, как выбрать это подмножество элементов для перемещения назад.
Поскольку нам нужен лексикографически наименьший массив, мы ищем какой-то жадный подход, который выбирает наименьший возможный элемент на следующей позиции один за другим, слева направо.
- Какое наименьшее число может стоять в начале нашего результирующего массива? Конечно, минимум. Это означает, что все элементы перед минимумом должны быть перемещены назад и увеличены на один.
- Какое наименьшее число мы можем иметь на втором месте, учитывая, что у нас есть минимум на первых позициях? Либо наименьший элемент справа от минимума, либо наименьший элемент среди тех, кто уже перемещен назад.
- ...
Анализируя этот подход, мы видим, что, двигаясь слева направо, мы продолжаем выбирать элементы из последовательности минимумов суффикса и продолжаем увеличивать множество элементов, которые мы должны переместить вправо, чтобы "извлечь" эту последовательность из начального массива. В какой-то момент следующий наименьший элемент приходит не из последовательности минимумов суффикса, а из кучи целых чисел, которые мы перемещаем вправо. В этот момент все оставшиеся элементы должны быть перемещены вправо один раз (то есть увеличены на $$$1$$$), а затем перечислены в отсортированном порядке.
Таким образом, ответ всегда состоит из нескольких первых элементов последовательности минимумов суффикса, начиная с глобального минимума, а затем всех остальных элементов, увеличенных на $$$1$$$ и отсортированных в возрастающем порядке. Чтобы найти точку, где мы переключаемся от последовательности минимумов суффикса к перемещенным элементам, удобно предварительно вычислить минимумы и сохранить множество тех элементов, которые мы уже переместили вправо.
Это решение работает за $$$O(n \log n)$$$, наряду со многими другими.
Code#include <bits/stdc++.h>
using namespace std;
#ifdef LOCAL
#define eprintf(...) fprintf(stderr, __VA_ARGS__)
#else
#define eprintf(...) 42
#endif
using ll = long long;
using ld = long double;
using D = double;
using uint = unsigned int;
template<typename T>
using pair2 = pair<T, T>;
#define pb push_back
#define mp make_pair
#define all(x) (x).begin(),(x).end()
#define fi first
#define se second
mt19937_64 rng(chrono::steady_clock::now().time_since_epoch().count());
void solve()
{
int n;
scanf("%d", &n);
vector<int> a(n);
for (int i = 0; i < n; i++) scanf("%d", &a[i]);
vector<int> front(n);
int frontfront = n;
int frontback = n;
multiset<int> back;
for (int i = n - 1; i >= 0; i--)
{
if (frontfront >= frontback || a[i] <= front[frontfront]) front[--frontfront] = a[i];
else back.insert(a[i] + 1);
while (frontfront < frontback && !back.empty() && front[frontback - 1] > *back.begin())
{
back.insert(front[frontback - 1] + 1);
frontback--;
}
}
vector<int> answer;
for (int i = frontfront; i < frontback; i++) answer.pb(front[i]);
for (auto t : back) answer.pb(t);
for (auto t : answer) printf("%d ", t);
printf("\n");
}
int main()
{
int NT = 1;
scanf("%d", &NT);
for (int T = 1; T <= NT; T++)
{
solve();
}
return 0;
}
Div1C
Прежде всего воспользуемся идеей бинарного поиска по ответу. Пусть мы сейчас проверяем, можно ли набрать ответ $$$k$$$.
Переберем все нужные нам координаты вертикальных прямых. Для этого заметим, что есть смысл перебирать только те, у которых прямые совпадают по Y-координате хотя бы с одной из точек. Очевидно, что в таком случае необходимых нам вертикальных прямых будет порядка $$$O(n)$$$.
Во время перебора вертикальной прямой мы будем поддерживать два дерева отрезков на сумму: одно для левой половины плоскости и второе для правой. $$$t_y$$$ в каждом из деревьев отрезков будет означать, сколько есть точек с Y-координатой $$$y$$$ в соответствующей половине плоскости. В каждом из деревьев отрезков посмотрим, можно ли разделить половину плоскости на две части прямой, параллельной оси абсцисс, так, чтобы в обеих частях было хотя бы по $$$k$$$ точек; и, если сделать это можно, то найдем множество подходящих прямых — очевидно, это будет некий отрезок $$$[y_{l}, \, y_{r}]$$$. Если пересечение получившихся отрезков в обоих деревьях отрезков не пустое, то мы нашли ответ. Сделать это можно спуском по дереву за время $$$O(\log n)$$$.
Итак, итоговое время работы описанного решения есть $$$O(n \log^2 n)$$$.
Код#include <math.h>
#include <unordered_set>
#include <unordered_map>
#include <map>
#include <iostream>
#include <fstream>
#include <vector>
#include <set>
#include <array>
#include <cstring>
#include <ctime>
#include <cassert>
#include <string_view>
#include <functional>
#include <sstream>
#include <numeric>
#include <cmath>
#include <deque>
#include <list>
#include <algorithm>
#include <iomanip>
using namespace std;
using i64 = long long;
using ui32 = unsigned int;
using ui64 = unsigned long long;
#define all(a) (a).begin(), (a).end()
struct Tree;
Tree* NewNode();
struct Count {
int left = 0;
int right = 0;
void Add(int delta) {
left += delta;
if (delta < 0) {
right -= delta;
}
}
void operator += (const Count& c) {
left += c.left;
right += c.right;
}
int GetMin() {
return min(left, right);
}
};
struct Tree {
Count count;
Tree* left = nullptr;
Tree* right = nullptr;
void Add(int l, int r, int p, int delta = 1) {
count.Add(delta);
if (r - l == 1) {
return;
}
int mid = (l + r) / 2;
if (p < mid) {
if (left == nullptr) {
left = NewNode();
}
left->Add(l, mid, p, delta);
} else {
if (right == nullptr) {
right = NewNode();
}
right->Add(mid, r, p, delta);
}
}
Count LeftCount() {
if (left) {
return left->count;
}
return {};
}
Count RightCount() {
if (right) {
return right->count;
}
return {};
}
void Remove(int l, int r, int p) {
Add(l, r, p, -1);
}
};
Tree nodes[7000000];
Tree* NewNode() {
static Tree* nextNode = nodes;
return nextNode++;
}
struct Solver {
struct Point {
int x, y;
bool operator < (const Point& p) const {
return x < p.x;
}
};
int max = 0;
int bx = 0;
int by = 0;
bool FindBest(int l, int r, Tree* node, const Count& left = {}, const Count& right = {}) {
if (node == nullptr) {
return false;
}
int mid = (l + r) / 2;
Count newLeft = node->LeftCount();
Count newRight = node->RightCount();
newLeft += left;
newRight += right;
int mn = min(newLeft.GetMin(), newRight.GetMin());
bool updated = false;
if (mn > max) {
max = mn;
by = mid;
updated = true;
}
if (mn == newLeft.GetMin()) {
if (FindBest(mid, r, node->right, newLeft, right)) {
return true;
}
} else {
if (FindBest(l, mid, node->left, left, newRight)) {
return true;
}
}
return updated;
}
void Solve(istream& cin, ostream& cout) {
int n;
cin >> n;
vector<Point> a(n);
int t9 = 1000000001;
#ifdef pperm
t9 = 100;
#endif
Tree* tree = NewNode();
for (Point& p : a) {
cin >> p.x >> p.y;
tree->Add(-t9, t9, p.y);
}
sort(all(a));
for (int i = 0; i < n;) {
int j = i + 1;
while (j < n && a[j].x == a[i].x) {
++j;
}
if (FindBest(-t9, t9, tree)) {
bx = a[i].x;
}
for (;i < j; ++i) {
tree->Remove(-t9, t9, a[i].y);
}
}
cout << max << '\n' << bx << ' ' << by << endl;
}
};
int main(int argc, char* args[]) {
#ifdef pperm
ifstream cin("/home/pperm86/My/Codeforces/input.txt");
#endif
ios_base::sync_with_stdio(false);
cin.tie(NULL);
#ifndef pperm
srand(time(0));
#endif
int T = 1;
cin >> T;
for (int iTest = 1; iTest <= T; ++iTest) {
Solver solver{};
solver.Solve(cin, cout);
}
#ifdef pperm
cout << clock() / static_cast<double>(CLOCKS_PER_SEC) << endl;
#endif
return 0;
}
Div1D
Сожмем граф в компоненты сильной связности. Внутри компоненты каждый гонец может перемещаться между любыми парами вершин и тем самым посетить все. Будем теперь решать задачу уже для ориентированного ациклического графа.
Проверим наличие ответа, Предположим, что все гонцы уже знают план победы, и попробуем разослать их так, чтобы каждая вершина была посещена хотя бы раз. Для этого необходимо декомпозировать граф на пути так, чтобы:
- каждая вершина принадлежала хотя бы одному пути;
- в каждой вершине начиналось не больше $$$a[i]$$$ путей (где $$$a[i]$$$ — количество гонцов, изначально находящихся в вершине);
- пути могли пересекаться.
Возьмем исток $$$s$$$ и сток $$$t$$$, путь же теперь можно представить как последовательность $$$s$$$, $$$u_1$$$, ..., $$$u_k$$$, $$$t$$$.
Разделим $$$u$$$ на $$$u_{in}$$$ и $$$u_{out}$$$ и будем считать, что вершина принадлежит $$$u$$$ хотя бы одному пути, если был хотя бы один переход из $$$u_{in}$$$ в $$$u_{out}$$$. Проведем следующие ребра:
- из $$$s$$$ в $$$u_{in}$$$ с пропускной способностью $$$cap = a[u]$$$;
- из $$$u_{in}$$$ в $$$u_{out}$$$ с $$$cap = inf$$$ и условием потока через ребро $$$f \geq 1$$$;
- из $$$u_{out}$$$ в $$$t$$$ с $$$cap = inf$$$;
- из $$$u_{out}$$$ в $$$v_{in}$$$ с $$$cap = inf$$$ для всех рёбер (u, v) в исходном графе.
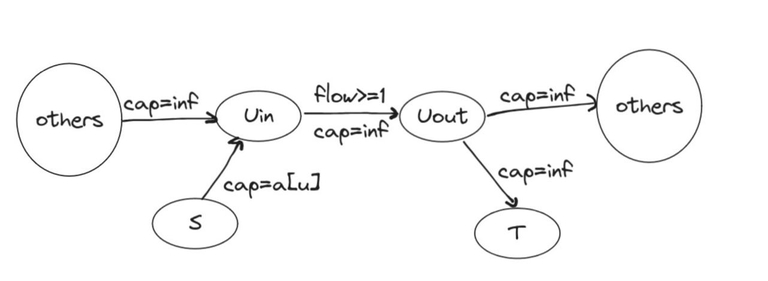
Что и эквивалентно нахождению потока с ограничениями в данном графе.
Для этого создадим фиктивный исток $$$s'$$$ и сток $$$t'$$$, теперь для каждого ребра $$$(u_{in}, u_{out})$$$ c потоком через него $$$1 \le f \le inf$$$ сделаем следующую замену, проведя ребра:
- из $$$u_{in}$$$ в $$$u_{out}$$$ с $$$cap = inf - 1$$$;
- из $$$s'$$$ в $$$u_{out}$$$ с $$$cap = 1$$$;
- из $$$u_{in}$$$ в $$$t'$$$ с $$$cap = 1$$$;
- из $$$t$$$ в $$$s$$$ с $$$cap = inf$$$.
Нахождение потока удовлетворяющего ограничениям эквивалентно нахождению максимального потока из $$$s'$$$ в $$$t'$$$, и если он равен количеству вершин, то значит ответ гарантированно существует, иначе можно вывести $$$-1$$$ уже на этом шаге.

Теперь минимизируем количество гонцов, которым изначально известен план. Заметим, что:
- нет смысла гонцам перемещаться, пока не узнают план;
- нет смысла передавать план более чем одному гонцу из одного города.
Пробуем учесть это при построении. Вместо добавления рёбер из истока в $$$u_{in}$$$ поступим так:
- создадим вершину $$$u_{cnt}$$$ для контроля количества гонцов и проведём рёбра:
- из $$$s$$$ в $$$u_{cnt}$$$ с $$$cap = a[u]$$$;
- из $$$u_{cnt}$$$ в $$$u_{out}$$$ с $$$cap = a[u]$$$;
- из $$$u_{cnt}$$$ в $$$u_{in}$$$ с $$$cap = 1$$$, $$$cost = 1$$$.
- всем остальным рёбрам зададим нулевую стоимость.
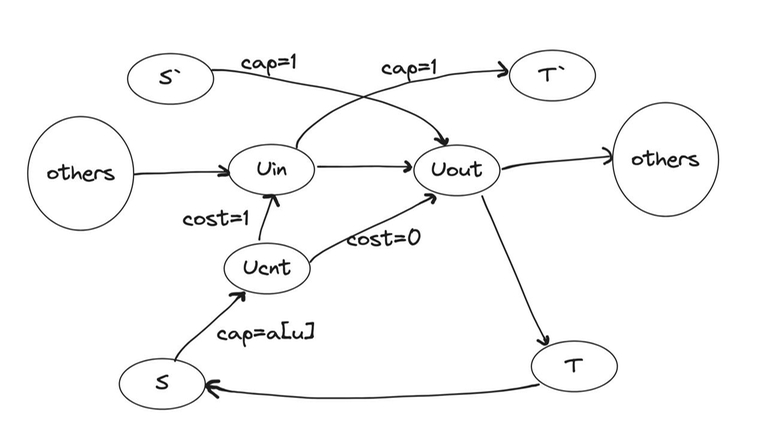
Что в свою очередь эквивалентно тому, что в результате все $$$a[i]$$$ гонцов узнают план, но, если в наш город никто не пришел, то собственноручно расскажем ровно одному гонцу из этого числа заплатив при этом $$$cost=1$$$ человека.
Ответом на задачу является минимальная стоимость максимального потока из $$$s'$$$ в $$$t'$$$ при таком построении графа. Доказательство следует из построения графа.
MCMF можно считать за $$$O(n^2m^2)$$$ или $$$O(n^3m)$$$ для любых графов, но в стоит заметить, что величина потока f ограничена n и имеем решение за $$$O(fnm)$$$ при использовании Форда-Беллмана или $$$O(fm\log n)$$$ при использовании Дейкстры с потенциалами.
Из интересного, заметим что в результате получили $$$3n$$$ вершин и $$$m + 7n$$$ ребер. При аккуратном написании MCMF вполне укладывается в TL.
Код#define _CRT_SECURE_NO_WARNINGS
#include<iostream>
#include<fstream>
#include<vector>
#include<stack>
#include<queue>
#include<set>
#include<map>
#include<array>
#include<unordered_set>
#include<unordered_map>
#include<cstring>
#include<string>
#include<memory>
#include<iomanip>
#include<cassert>
#include<cmath>
#include<random>
#include<algorithm>
#include<chrono>
#pragma GCC optimize("O3,unroll-loops")
#pragma GCC target("avx2,bmi,bmi2,lzcnt,popcnt")
#define int long long
#define ld long double
#define endl '\n'
using namespace std;
constexpr int N = 500;
vector<int> g[N], gr[N], gcmp[N];
int a[N], acmp[N], used[N], color[N], cur_color = 0;
vector<int> order, cmp;
void dfs1(int u) {
for (int v : g[u]) {
if (used[v] == 0) {
used[v] = 1;
dfs1(v);
}
}
order.push_back(u);
}
void dfs2(int u) {
for (int v : gr[u]) {
if (used[v] == 0) {
used[v] = 1;
dfs2(v);
}
}
color[u] = cur_color;
}
inline array<int, 3> getInd(int u) {
return { 3 * u, 3 * u + 1, 3 * u + 2 };
}
constexpr int INF = 0x3f3f3f3f;
struct MCMF {
struct rib {
int b, u, c, f;
size_t back;
};
MCMF(int size) : n(size), g_mcmf(size) {};
int n;
vector<vector<rib>> g_mcmf;
void rebuild(int sz) {
n = sz, g_mcmf.clear(); g_mcmf.resize(sz);
}
void add_rib(int a, int b, int u, int c) {
rib r1 = { b, u, c, 0, g_mcmf[b].size() };
rib r2 = { a, 0, -c, 0, g_mcmf[a].size() };
g_mcmf[a].push_back(r1);
g_mcmf[b].push_back(r2);
}
pair<int, int> get_flow(int s, int t, int maxflow = INF) {
int flow = 0, cost = 0;
while (flow < maxflow) {
vector<int> id(n, 0);
vector<int> d(n, INF);
vector<int> q(n);
vector<int> p(n);
vector<size_t> p_rib(n);
int qh = 0, qt = 0;
q[qt++] = s;
d[s] = 0;
while (qh != qt) {
int v = q[qh++];
id[v] = 2;
if (qh == n) qh = 0;
for (size_t i = 0; i < g_mcmf[v].size(); ++i) {
rib& r = g_mcmf[v][i];
if (r.f < r.u && d[v] + r.c < d[r.b]) {
d[r.b] = d[v] + r.c;
if (id[r.b] == 0) {
q[qt++] = r.b;
if (qt == n) qt = 0;
}
else if (id[r.b] == 2) {
if (--qh == -1) qh = n - 1;
q[qh] = r.b;
}
id[r.b] = 1;
p[r.b] = v;
p_rib[r.b] = i;
}
}
}
if (d[t] == INF) break;
int addflow = maxflow - flow;
for (int v = t; v != s; v = p[v]) {
int pv = p[v]; size_t pr = p_rib[v];
addflow = min(addflow, g_mcmf[pv][pr].u - g_mcmf[pv][pr].f);
}
for (int v = t; v != s; v = p[v]) {
int pv = p[v]; size_t pr = p_rib[v], r = g_mcmf[pv][pr].back;
g_mcmf[pv][pr].f += addflow;
g_mcmf[v][r].f -= addflow;
cost += g_mcmf[pv][pr].c * addflow;
}
flow += addflow;
}
return { flow, cost };
}
};
void solve() {
for (int i =0 ; i < N; i++)
{
g[i] = {};
gr[i] = {};
gcmp[i] = {};
}
memset(a, 0, sizeof a);
memset(acmp, 0, sizeof acmp);
memset(used, 0, sizeof used);
memset(color, 0, sizeof color);
cur_color = 0;
order = {};
cmp = {};
int n, m; cin >> n >> m;
for (int i = 0; i < n; i++) {
g[i].clear();
gr[i].clear();
}
for (int i = 0; i < n; i++) cin >> a[i];
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v; u--, v--;
g[u].push_back(v);
gr[v].push_back(u);
}
order.clear();
memset(used, 0, sizeof(used[0]) * n);
for (int i = 0; i < n; i++) {
if (used[i] == 0) {
used[i] = 1;
dfs1(i);
}
}
memset(used, 0, sizeof(used[0]) * n);
for (int i = 0; i < n; i++) {
int u = order[n - i - 1];
if (used[u] == 0) {
used[u] = 1;
dfs2(u);
cur_color++;
}
}
// for (int i = 0; i < n; i++) cout << color[i] << " "; cout << endl;
memset(acmp, 0, sizeof(acmp[0]) * cur_color);
for (int i = 0; i < n; i++) {
acmp[color[i]] += a[i];
for (int v : g[i]) {
if (color[i] != color[v]) {
gcmp[color[i]].push_back(color[v]);
}
}
}
for (int i = 0; i < cur_color; i++) {
auto& e = gcmp[i];
sort(e.begin(), e.end());
e.erase(unique(e.begin(), e.end()), e.end());
// cout << i << " " << acmp[i] << ": ";
// for (int v : e) cout << v << " "; cout << endl;
}
int s = 3 * cur_color, t = s + 1, so = t + 1, to = so + 1;
MCMF gg(to + 1);
for (int i = 0; i < cur_color; i++) {
auto [uin, uout, ucnt] = getInd(i);
gg.add_rib(s, ucnt, acmp[i], 0);
gg.add_rib(ucnt, uin, 1, 1);
gg.add_rib(ucnt, uout, INF, 0);
gg.add_rib(uin, uout, INF, 0);
gg.add_rib(uout, t, INF, 0);
gg.add_rib(so, uout, 1, 0);
gg.add_rib(uin, to, 1, 0);
}
gg.add_rib(t, s, INF, 0);
for (int i = 0; i < cur_color; i++) {
auto [uin, uout, ucnt] = getInd(i);
for (int v : gcmp[i]) {
auto [vin, vout, vcnt] = getInd(v);
gg.add_rib(uout, vin, INF, 0);
}
}
auto [flow, cost] = gg.get_flow(so, to);
// cout << flow << " " << cost << endl;
if (flow < cur_color) {
cout << -1 << endl;
return;
}
cout << cost << endl;
}
signed main() {
// freopen("input.txt", "r", stdin);
ios_base::sync_with_stdio(false);
cin.tie(0); cout.tie(0);
int q; cin >> q; while (q--)
solve();
}
Div1E1+E2
Для удобства номы будем называть группами, включающими какие-то города.
Ключевым условием является то, что каждой специализации может соответствовать не более одной задачи. Тем самым города из разных групп должны иметь "практически отсортированное" значение силы при увеличении порядкового номера группы.
Обозначим за $$$[l_i, r_i]$$$ отрезок, включающий все силы городов в группе $$$i$$$, где $$$r_i$$$ — максимальная сила города из этой группы, а $$$l_i$$$ — минимальная. При $$$l_i \le r_{i+2}$$$ невозможно построить контест, так как между городами соответствующим $$$l_i$$$ и $$$r_{i+2}$$$ должна быть разница хотя бы в 2 задачи, но они могут отличаться максимум на 1 задачу по специализации. После этого задача сводится к рассмотрению двух соседних групп и последующей проверки сложностей задач на соответствие линейным условиям каждой группы.
Рассмотрим 2 случая:
При $$$l_i \ge r_{i+1}$$$ для соблюдения порядка достаточно добавить несколько задач (а точнее всего 2) сложности из отрезка $$$[r_{i+1} + 1, l_i]$$$.
В противном случае каждый город $$$i$$$-й группы, лежащий в пересечении, должен решить задачу со своей специализацией. При этом ни одна задача не может быть в отрезке $$$[l_i + 1, r_{i+1}]$$$, так как город, имеющий наибольшую силу в группе $$$i+1$$$, решит не меньше задач, чем самый слабый город $$$i$$$-й группы, чего нам допускать нельзя. Для соблюдения порядка с остальными группами достаточно добавить 2 задачи сложности $$$r_{i+1} + 1$$$ (в отличие от первого случая, в силу того, что не может быть $$$l_i \le r_{i+2}$$$, здесь можно сразу определить подходящую сложность задач, но их можно будет расставить по тому же алгоритму, что и для 1-го случая).
Можно заметить, что при добавлении двоек задач им нужно выбирать не используемую никем спецификацию (так как мы ее в принципе не используем, но иначе это может породить коллизии).
Получаем, что нам необходимо расставить задачи с заданной спецификацией, которую сможет решить город из пересечения групп, то есть ее сложность должна быть не больше мудрости этого города, а так же расставить по 2 задачи некоторых сложностей для соблюдения порядка между группами. Эти трудности появляются из-за возможного пересечения с другими группами при использовании $$$r_{i+1} + 1$$$ как сложности задачи и возможных коллизий спецификаций городов, из-за чего город из слабой группы может решить задачу, которую мы для него не предполагали, тем самым нарушив условия строгости между группами.
Большая часть проблем не может возникнуть при $$$m=2$$$, поэтому сказанное выше уже является решением (без небольших доработок) простой версии задачи.
Сначала решим, как выбрать сложность для задач с определенной спецификацией. Для этого запретим использовать спецификацию задач, соответствующую городам, которые образуют 2-й случай (то есть из $$$i+1$$$-й группы), со сложностью $$$[l_i, b_j]$$$, где j — номер такого города. Также, как было указано, мы не можем иметь вне зависимости от типа задачу из отрезка $$$[l_i + 1, r_{i+1}]$$$. Для определения сложности достаточно ее выставить максимально возможной (равной мудрости) и затем постепенно снижать, пока не попадем в разрешенную сложность.
Чтобы разрешить проблему из первого случая, поставим барьеры по 2 задачи со сложностью, равной силе некоторого города везде, где это возможно.
Если для данной конфигурации существует ответ, то мы его таким образом гарантированно построим, использовав не более $$$3 \cdot n$$$ задач. После всех вычислений нужно проверить, удовлетворяет ли построенный нами контест условиям задачи, и вывести -1 в противном случае.
Код/**
* author: tourist
* created: 01.12.2024 18:36:51
**/
#undef _GLIBCXX_DEBUG
#include <bits/stdc++.h>
using namespace std;
#ifdef LOCAL
#include "algo/debug.h"
#else
#define debug(...) 42
#endif
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
int tt;
cin >> tt;
while (tt--) {
int n, m;
cin >> n >> m;
vector<int> a(n), b(n), c(n);
set<int> s;
for (int i = 0; i < n; i++) {
cin >> a[i] >> b[i] >> c[i];
s.insert(c[i]);
}
vector<vector<int>> vs(m);
for (int i = 0; i < m; i++) {
int foo;
cin >> foo;
vs[i].resize(foo);
for (int j = 0; j < foo; j++) {
cin >> vs[i][j];
--vs[i][j];
}
}
const int inf = int(1.01e9);
vector<int> min_a(m, inf);
vector<int> max_a(m, -1);
for (int i = 0; i < m; i++) {
for (int j : vs[i]) {
min_a[i] = min(min_a[i], a[j]);
max_a[i] = max(max_a[i], a[j]);
}
}
auto Unify = [&](vector<pair<int, int>>& bad) {
sort(bad.begin(), bad.end());
int ptr = 0;
for (int i = 1; i < int(bad.size()); i++) {
if (bad[i].first <= bad[ptr].second + 1) {
bad[ptr].second = max(bad[ptr].second, bad[i].second);
} else {
bad[++ptr] = bad[i];
}
}
bad.resize(ptr + 1);
};
vector<pair<int, int>> bad;
for (int id = 0; id < m - 1; id++) {
if (min_a[id] < max_a[id + 1]) {
bad.emplace_back(min_a[id] + 1, max_a[id + 1]);
}
}
Unify(bad);
vector<int> ctr(n);
for (int i = 0; i < m; i++) {
for (int x : vs[i]) {
ctr[x] = i;
}
}
vector<pair<int, int>> tasks;
int unused = 0;
vector<int> order(n);
iota(order.begin(), order.end(), 0);
sort(order.begin(), order.end(), [&](int i, int j) {
return a[i] > a[j];
});
multiset<int> before, after;
for (int i = 0; i < n; i++) {
after.insert(ctr[i]);
}
{
int beg = 0;
while (beg < n) {
int end = beg;
while (end + 1 < n && a[order[end + 1]] == a[order[end]]) {
end += 1;
}
for (int i = beg; i <= end; i++) {
before.insert(ctr[order[i]]);
after.erase(after.find(ctr[order[i]]));
}
if (!before.empty() && !after.empty() && *prev(before.end()) <= *after.begin()) {
for (int i = 0; i < 2; i++) {
do {
unused += 1;
} while (s.find(unused) != s.end());
tasks.emplace_back(a[order[end]], unused);
}
}
beg = end + 1;
}
}
map<int, int> add;
for (int id = 0; id < m - 1; id++) {
for (int i : vs[id]) {
if (a[i] <= max_a[id + 1]) {
if (add.find(c[i]) == add.end()) {
add[c[i]] = b[i];
} else {
add[c[i]] = min(add[c[i]], b[i]);
}
}
}
}
map<int, vector<pair<int, int>>> kill;
for (int id = 1; id < m; id++) {
for (int i : vs[id]) {
if (a[i] >= min_a[id - 1]) {
kill[c[i]].push_back({min_a[id - 1] + 1, b[i]});
}
}
}
for (auto& [type, x] : add) {
auto& k = kill[type];
Unify(k);
int dif = x;
while (true) {
bool changed = false;
{
auto it = lower_bound(bad.begin(), bad.end(), make_pair(dif + 1, -1));
if (it != bad.begin()) {
it = prev(it);
if (it->second >= dif) {
dif = it->first - 1;
changed = true;
}
}
}
{
auto it = lower_bound(k.begin(), k.end(), make_pair(dif + 1, -1));
if (it != k.begin()) {
it = prev(it);
if (it->second >= dif) {
dif = it->first - 1;
changed = true;
}
}
}
if (!changed) {
break;
}
}
tasks.emplace_back(dif, type);
}
debug(tasks);
vector<int> all;
map<int, int> spec;
for (auto& [x, y] : tasks) {
all.push_back(x);
assert(spec.find(y) == spec.end());
spec[y] = x;
}
sort(all.begin(), all.end());
vector<int> solved(n);
for (int i = 0; i < n; i++) {
solved[i] = int(upper_bound(all.begin(), all.end(), a[i]) - all.begin());
if (spec.find(c[i]) != spec.end() && spec[c[i]] > a[i] && spec[c[i]] <= b[i]) {
solved[i] += 1;
}
}
vector<int> min_solved(m, inf);
vector<int> max_solved(m, -1);
for (int i = 0; i < m; i++) {
for (int j : vs[i]) {
min_solved[i] = min(min_solved[i], solved[j]);
max_solved[i] = max(max_solved[i], solved[j]);
}
}
bool win = true;
for (int id = 0; id < m - 1; id++) {
if (min_solved[id] <= max_solved[id + 1]) {
win = false;
break;
}
}
if (win) {
cout << tasks.size() << '\n';
for (auto& [x, y] : tasks) {
cout << x << " " << y << '\n';
}
} else {
cout << -1 << '\n';
}
}
return 0;
}
Div1F1
Можно заметить, что если строка содержит правильное количество количество символов 'Y', 'D', 'X' и не имеет двух подряд идущих одинаковых символов, то её можно получить при помощи заданных операций.
Чтобы показать это, приведем алгоритм, который построит некоторую последовательность операций, приводящих к заданной строке. Пойдем с конца (со строки, которую хотим получить к пустой строке) постепенно откусывая символы.
Посмотрим на текущую строку. Не умаляя общности, пусть первый её символ равен 'Y'. Тогда в строке должна встречаться строка 'DX' и/или строка 'XD'. Это верно потому что для отсутствия 'DX' и 'XD' необходимо чтобы между любой парой символов не равных 'Y' находился хотя бы один символ 'Y'. Этого, в лучшем случае, можно добиться поставив 'Y' через каждый символ. Таким образом, символов не равных 'Y' при наличии $$$n-1$$$ 'Y' можно поставить не более $$$n$$$. Но $$$3n-1 \gt n$$$ при $$$n \gt 0$$$.
Получается, что строка имеет вид 'Y...ADXB...'.
Если A $$$\neq$$$ B, мы можем удалить символы 'Y', 'D', 'X' и ничего не сломаем.
Если A = B, то A = B = 'Y', так как A != 'D' и A != 'X'.
Тогда строка имеет вид 'Y...YDXY...', и мы можем удалить подстроку 'YDX' и останется все еще несломанная строка 'Y...Y...'.
Div1F2
Выделим из строки подотрезки, полностью состоящие из '?'. Для каждого обозначим его длину за $$$len_i$$$ и два соседних символа (стоящих слева и справа) за $$$l_i$$$, $$$r_i$$$. (Если правый и/или левый символ отстуствуют, возьмем их за '#', как символ, не совпадающий ни с каким из нас интересующих.
Выпишем тривиальные ограничения на количество доступных символов каждого вида на отрезке. Очевидно, что символов каждого вида не может быть больше, чем $$$\frac{len_i+1}{2}$$$: поставим по одному символу через каждый символ. Но если, например, слева у нас стоял символ 'Y', то количество позиций, где мы можем поместить 'Y' сокращается на $$$1$$$. Итого мы можем поставить не более $$$\frac{len+1-(l_i=b)-(r_i=b)}{2}$$$ символов типа b. Выпишем такие ограничения для каждого типа символов и обозначим их за $$$Y, D, X$$$ соответственно.
Оказывается, что мы можем расставить $$$y$$$ символов 'Y', $$$d$$$ символов 'D' и $$$x$$$ символов 'X', тогда и только тогда, когда $$$y+d+x=len_i$$$ и $$$0\leq y \leq Y, 0 \leq d \leq D, 0 \leq x \leq X$$$. Это можно доказать по индукции или проверить стрессом на небольших значениях. Отсюда заключаем, что чтобы мы имели возможность расставить $$$x, d, y$$$ символов каждого вида, надо чтобы выполнялись неравенства выше.
Из равенства $$$y+d+x=len_i$$$ выразим $$$d=len_i - (x+y)$$$.
Получаются три ограничения: $$$0\leq x \leq X, 0 \leq y \leq Y, 0 \leq len_i - (x+y) \leq D$$$. Первые два образуют прямоугольник, а третье отрезает от него два угла под углом $$$45$$$ градусов. А это выпуклый многоугольник.
Получается, что если для каждого отрезка из '?' выписать многоугольник и просуммировать их суммой Минковского, получатся ограничения на всю строку.
Так как в сумме минковского (после склеивания колиннеарных подряд идущих отрезков) будет не более 6 точек, можно написать жадный алгоритм, который каждому '?' последовательно пробует сопоставить нужный символ.
Итоговая асимптотика $$$O(n)$$$ с некоторой констаной.
Код#pragma GCC optimize("Ofast")
#include <iostream>
#include <cmath>
#include <cstdint>
#include <vector>
#include <string>
#include <iomanip>
#include <set>
#include <map>
#include <unordered_map>
#include <unordered_set>
#include <algorithm>
#include <functional>
#include <queue>
#include <fstream>
#include <random>
//#include <numbers>
#include <optional>
#include <deque>
#include <sstream>
#include <list>
#include <chrono>
#include <thread>
#include <cassert>
using namespace std;
using i64 = int64_t;
using ui64 = uint64_t;
#define YN(b) if (b) cout << "YES\n"; else cout << "NO\n";
template<typename T>
istream& operator>>(istream& is, vector<T>& v) { for (auto &e: v) { is >> e; } return is; }
template<typename T>
ostream& operator<<(ostream& os, vector<T>& v) { for (auto &e: v) { os << e << " "; } return os; }
template<typename T, typename V>
istream& operator>>(istream& is, pair<T, V>& v) { return is >> v.first >> v.second; }
template<typename T, typename V>
ostream& operator<<(ostream& os, pair<T, V>& v) { return os << v.first << " " << v.second; }
const int64_t md = 1e9+7;
int dx[4] = {-1, 0, 1, 0};
inline int64_t sqr(int64_t x) {
return x * x;
}
inline int popcount(int64_t x) {
int c = 0;
while (x) c += x & 1, x >>= 1;
return c;
}
pair<int64_t, int64_t> inter(pair<int64_t, int64_t> a, pair<int64_t, int64_t> b) {
return {max(a.first, b.first), min(a.second, b.second)};
}
struct pt {
using T = int;
using V = int64_t;
T x = 0, y = 0;
pt() = default;
pt(T x, T y) : x(x), y(y) {}
inline pt& operator-=(const pt& other) {
x -= other.x;
y -= other.y;
return *this;
}
inline pt operator-(const pt& other) const {
pt copy(*this);
copy -= other;
return copy;
}
inline pt& operator+=(const pt& other) {
x += other.x;
y += other.y;
return *this;
}
inline pt operator+(const pt& other) const {
pt copy(*this);
copy += other;
return copy;
}
V operator^(const pt& other) const {
return (V)x * other.y - (V)y * other.x;
}
V operator*(const pt& other) const {
return (V)x * other.x + (V)y * other.y;
}
void print() const {
cerr << x << " " << y << "\n";
}
bool operator==(const pt&) const = default;
};
inline bool in_triangle(const pt& a, const pt& b, const pt& c, const pt& point) {
int64_t s1 = abs((b - a) ^ (c - a));
int64_t s2 = abs((a - point) ^ (b - point)) + abs((b - point) ^ (c - point)) + abs((c - point) ^ (a - point));
return s1 == s2;
}
struct mi {
size_t i = 0;
size_t ni = 1;
const size_t m;
mi(size_t m) : m(m) {}
void add() {
++i;
if (++ni == m) ni = 0;
}
};
int64_t orientation(pt a, pt b, pt c) {
return -((int64_t)a.x * (b.y - c.y) + (int64_t)b.x * (c.y - a.y) + (int64_t)c.x * (a.y - b.y));
}
inline bool comp(pt a, pt b) {
auto cp = a ^ b;
if (!cp) {
return a * a < b * b;
}
return (pt::V)a.x * b.x < 0 ? (a.x > b.x) : cp > 0;
}
struct NMP {
array<pt, 13> pts;
int len = 0;
template<typename... Args>
void emplace_back(Args&& ...p) {
new (&pts[len++]) pt(p...);
}
void push_back(const pt& x) {
pts[len++] = x;
}
pt& operator[](size_t x) {
return pts[x];
}
size_t size() const {
return len;
}
const pt& operator[](size_t x) const {
return pts[x];
}
pt* begin() {
return &pts[0];
}
pt* end() {
return &pts[len];
}
void resize(size_t x) {
len = x;
}
};
struct poly {
using P = pt;
NMP pts;
void add(const P& p) {
pts.push_back(p);
}
template<typename... Args>
void emplace(Args&& ...p) {
pts.emplace_back(p...);
}
void sort() {
size_t min_id = 0;
for (size_t i = 1; i < pts.size(); ++i) {
if (pts[i].y < pts[min_id].y || (pts[i].y == pts[min_id].y && pts[i].x < pts[min_id].x)) {
min_id = i;
}
}
std::rotate(pts.begin(), pts.begin() + min_id, pts.end());
auto p0 = pts[0];
std::sort(pts.begin(), pts.end(), [&](const P& a, const P& b) {
auto o = orientation(p0, a, b);
if (!o)
return (int64_t)(p0.x-a.x)*(p0.x-a.x) + (int64_t)(p0.y-a.y)*(p0.y-a.y)
< (int64_t)(p0.x-b.x)*(p0.x-b.x) + (int64_t)(p0.y-b.y)*(p0.y-b.y);
return o < 0;
});
}
void no_coll() {
if (pts.size() < 3) {
return;
}
size_t ptr = 1;
for (size_t j = 2; j < pts.size(); ++j) {
if ((pts[ptr] - pts[ptr - 1]) ^ (pts[j] - pts[ptr])) {
pts[++ptr] = pts[j];
continue;
}
pts[ptr] = pts[j];
}
pts.resize(ptr + 1);
}
poly operator+(const poly& other) const {
if (pts.size() == 1) {
poly c(other);
for (auto& p: c.pts) p += pts[0];
return c;
}
if (other.pts.size() < pts.size()) {
return other + *this;
}
// size at least 2s
poly res;
mi i(pts.size()), j(other.pts.size());
while (i.i < pts.size() && j.i < other.pts.size()) {
res.emplace(pts[i.i] + other.pts[j.i]);
auto a = (pts[i.ni] - pts[i.i]);
auto b = (other.pts[j.ni] - other.pts[j.i]);
auto cp = a ^ b;
if (cp < 0) {
j.add();
} else if (cp > 0) {
i.add();
} else if ((P::V)a.y * b.y >= 0) {
i.add();
j.add();
} else if (a.y > b.y) {
i.add();
} else {
j.add();
}
}
while (i.i < pts.size()) {
res.emplace(pts[i.i] + other.pts[0]);
i.add();
}
while (j.i < other.pts.size()) {
res.emplace(pts[0] + other.pts[j.i]);
j.add();
}
res.no_coll();
return res;
}
void print() {
for (auto &e: pts) {
cout << "(" << e.x << " " << e.y << ") ";
}
cout << "\n";
}
bool in(const pt& p) const {
if (pts.size() == 1) {
return pts[0] == p;
}
if (pts.size() == 2) {
return ((pts[0] - p) ^ (pts[1] - p)) == 0
&& min(pts[0].x, pts[1].x) <= p.x && p.x <= max(pts[0].x, pts[1].x)
&& min(pts[0].y, pts[1].y) <= p.y && p.y <= max(pts[0].y, pts[1].y);
}
for (int i = 2; i < pts.size(); ++i) {
if (in_triangle(pts[i], pts[i - 1], pts[0], p)) {
return true;
}
}
return false;
}
};
struct co {
array<int, 3> cst {};
poly p;
co() {
p.emplace(0, 0);
}
co(int l, int a, int b) {
cst = {
max(0, 1 + l - (a == 0) - (b == 0)) / 2,
max(0, 1 + l - (a == 1) - (b == 1)) / 2,
max(0, 1 + l - (a == 2) - (b == 2)) / 2
};
p.emplace(min(cst[0], l - cst[2]), max(0, l - cst[0] - cst[2]));
p.emplace(min(cst[0], l), max(0, l - cst[0] - cst[2]));
p.emplace(cst[0], min(cst[1], l - cst[0]));
p.emplace(min(l - cst[1], cst[0]), cst[1]);
p.emplace(max(0, l - cst[1] - cst[2]), min(l, cst[1]));
p.emplace(max(0, l - cst[1] - cst[2]), min(cst[1], l - cst[2]));
p.sort();
p.no_coll();
}
co operator+(const co& rhs) {
co res;
res.p = p + rhs.p;
for (int j = 0; j < 3; ++j) res.cst[j] = cst[j] + rhs.cst[j];
return res;
}
bool ok(int x, int y, int z) {
return x <= cst[0] && y <= cst[1] && z <= cst[2];
}
bool in(int x, int y, int z) {
return ok(x, y, z) && p.in(pt(x, y));
}
};
char idx[128]{};
string ydx = "YDX";
struct fenwick {
fenwick(int x) : t(x), n(x) {}
vector<int> t;
int n;
int sum (int r) {
int result = 0;
for (; r >= 0; r = (r & (r+1)) - 1)
result += t[r];
return result;
}
void inc (int i, int delta) {
for (; i < n; i = (i | (i+1)))
t[i] += delta;
}
};
using S = std::list<pair<short, int>>;
struct cmp {
bool operator()(S::iterator a, S::iterator b) const {
return a->second < b->second;
};
};
auto encode1(auto a, auto b) {
return a * 256 + b;
};
auto encode(auto it) {
auto prev = it++;
return encode1(prev->first, it->first);
};
auto erase_char(auto& curr_pos, S& str, fenwick& alive, auto& pos, auto it) {
auto curr = it;
auto prev = --it;
it = curr;
auto next = ++it;
if (next != str.end()) {
if (!pos[encode(curr)].count(curr)) {
exit(-1);
}
pos[encode(curr)].erase(curr);
}
if (prev != str.end()) {
if (!pos[encode(prev)].count(prev)) {
exit(-1);
}
pos[encode(prev)].erase(prev);
}
curr_pos.emplace_back(curr->first, alive.sum(curr->second) - 1);
alive.inc(curr->second, -1);
str.erase(curr);
if (next != str.end() && prev != str.end()) {
auto p = prev;
++p;
if (p != next) {
exit(-1);
}
pos[encode(prev)].emplace(prev);
}
};
bool is_ok(S::iterator x, S::iterator end) {
auto curr = x;
auto prev = --x;
auto next = ++curr;
if (prev != end && next != end) {
return prev->first != next->first;
}
return true;
}
auto got(auto& curr_pos, auto& str, auto& alive, auto& pos, vector<S::iterator> t) {
for (auto &e: t) {
erase_char(curr_pos, str, alive, pos, e);
}
};
auto relax(auto& curr_pos, auto& str, auto& alive, auto& pos, short sym, short co) {
auto &v = pos[co];
auto it = *v.begin();
auto A = it;
auto prev = --it;
it = A;
auto B = ++it;
auto next = ++it;
if (prev != str.end() && next != str.end() && prev->first == next->first) {
if (prev->first != sym) {
exit(-1);
}
got(curr_pos, str, alive, pos, {prev, A, B});
return false;
}
got(curr_pos, str, alive, pos, {A, B});
return true;
};
vector<array<pair<char, int>, 3>> solve_str(const string& s) {
S str;
fenwick alive(s.size());
for (int i = 0; i < s.size(); ++i) {
str.emplace_back(s[i], i);
alive.inc(i, 1);
}
auto it = str.begin();
map<int, set<decltype(it), cmp>> pos;
while (it != str.end()) {
auto prev = it++;
if (it == str.end()) break;
pos[encode(prev)].emplace(prev);
}
vector<pair<char, int>> curr_pos;
vector<decltype(it)> curr_t;
vector<array<pair<char, int>, 3>> res;
while (str.size()) {
it = str.begin();
auto curr = it++;
if (it == str.end()) {
exit(-1);
}
short code = curr->first;
erase_char(curr_pos, str, alive, pos, curr);
array<int, 2> candidates;
if (code == 'Y') {
candidates[0] = encode1('D', 'X');
candidates[1] = encode1('X', 'D');
} else if (code == 'X') {
candidates[0] = encode1('D', 'Y');
candidates[1] = encode1('Y', 'D');
} else {
candidates[0] = encode1('Y', 'X');
candidates[1] = encode1('X', 'Y');
}
bool ok = 0;
while (!ok) {
for (auto &c: candidates) {
if (!pos[c].size()) {
continue;
}
if (relax(curr_pos, str, alive, pos, code, c)) {
ok = 1;
res.emplace_back();
res.back()[0] = curr_pos[2];
res.back()[1] = curr_pos[1];
res.back()[2] = curr_pos[0];
curr_pos.clear();
break;
}
// A...ABCA, ABC removed
res.emplace_back();
for (int j = 0; j < 3; ++j) {
res.back()[j] = curr_pos.back(); // removed
res.back()[j].second += 1;
curr_pos.pop_back();
}
break;
}
}
}
reverse(res.begin(), res.end());
return res;
}
bool check(const string& s) {
array<int, 3> cnt{};
char prev = -1;
for (auto &e: s) {
if (e == '?') {
return false;
}
if (e != 'Y' && e != 'D' && e != 'X') {
return false;
}
if (e == prev) return false;
prev = e;
++cnt[idx[e]];
}
return cnt[0] == s.size() / 3 && cnt[1] == s.size() / 3 && cnt[2] == s.size() / 3;
}
optional<string> solve_fast1(string v) {
auto sv = v;
int N = v.size() / 3;
array<int, 3> rem{N, N, N};
for (auto &e: v) {
if (e == '?') continue;
--rem[idx[e]];
}
if (rem[0] < 0 || rem[1] < 0 || rem[2] < 0) return {};
vector<co> mink;
vector<pair<int, int>> segs;
for (int i = 0; i < v.size(); ++i) {
if (v[i] != '?') continue;
int j = i + 1;
while (j < v.size() && v[j] == '?') ++j;
mink.emplace_back(j - i, i > 0 ? idx[v[i - 1]] : 3, j < v.size() ? idx[v[j]] : 3);
segs.emplace_back(i, j - 1);
i = j - 1;
}
reverse(mink.begin(), mink.end());
reverse(segs.begin(), segs.end());
for (int i = 1; i < mink.size(); ++i) {
mink[i] = mink[i - 1] + mink[i];
}
if (mink.size()) {
mink.pop_back();
}
while (segs.size()) {
auto seg = segs.back();
segs.pop_back();
auto mk = mink.size() ? mink.back() : co();
if (mink.size()) {
mink.pop_back();
}
char prev = idx[seg.first ? v[seg.first - 1] : '?'];
char next_r = idx[seg.second + 1 < v.size() ? v[seg.second + 1] : '?'];
while (seg.first <= seg.second) {
char next = seg.first == seg.second ? next_r : -1;
bool found = 0;
for (int j = 0; j < 3; ++j) {
if (prev == j || next == j || !rem[j]) {
continue;
}
--rem[j];
auto cs = co(seg.second - seg.first, j, seg.second + 1 < v.size() ? idx[v[seg.second + 1]] : 3);
auto vv = mk + cs;
if (!vv.in(rem[0], rem[1], rem[2])) {
++rem[j];
continue;
}
v[seg.first++] = ydx[j];
prev = j;
found = 1;
break;
}
if (!found) {
return {};
}
}
}
return v;
}
optional<pair<vector<array<pair<char, int>, 3>>, string>> solve(string s) {
auto ww = solve_fast1(s);
if (!ww || !check(*ww)) {
return {};
}
return pair{solve_str(*ww), *ww};
}
signed main() {
ios::sync_with_stdio(0);
cin.tie(0);
cout.tie(0);
idx['Y'] = 0;
idx['D'] = 1;
idx['X'] = 2;
idx['?'] = 99;
int t;
cin >> t;
while (t--) {
string s;
cin >> s;
auto r = solve(s);
if (r) {
cout << "YES\n" << r->second << "\n";
for (auto &x: r->first) {
for (auto &e: x) {
cout << e.first << " " << e.second << " ";
}
cout << "\n";
}
} else {
cout << "NO\n";
}
}
}


