


Hi there.
The TopCoder Open 2023 Rules state that the first Online Round will be held on April 8, 2023 at 12:00 UTC-4, which is today.
But I still cannot see any options in the Active Contests menu of the Java Applet Arena. I've heard that the registration opens around 3-4 hours before the contest, so it should already be there, if my calculations are right.
Is it just me, or does anyone see the registration option?
P. S. There are no TopCoder entries at clist.by now, which is kinda strange. As I remember, in the previous years all TCO rounds were listed there.
UPD: It seems that dates specified in the Rules are no longer valid (hope the schedule would be updated).


 размера
 , а также
 запросов вида
 — определить количество элементов, больших
 , на отрезке
 .
 , ответ на запрос
 , online
 , хранится отсортированный вектор элементов массива
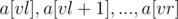 (в иностранных источниках такое дерево отрезков иногда называют merge tree). Объединять отсортированные вектора можно при помощи алгоритма STL merge().
 мы, как обычно, спускаемся к вершинам, подотрезки которых входят в целевой отрезок, и в каждой из этих вершин выполняем двоичный поиск, чтобы определить количество элементов, больших
 , online
 , если бы в каждой вершине была сохранена дополнительная информация.
 — отсортированный вектор, хранящийся в вершине
 ,
 и
 — отсортированные вектора, хранящиеся в её левом и правом потомках. Пусть в вершине
 и
 , такие что
 — индекс первого элемента, большего или равного
 , в массиве
 — аналогичный индекс в массиве
 первого элемента, большего
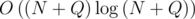 , ответ на запрос
 , то ответом на запрос
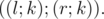
 , для запросов —
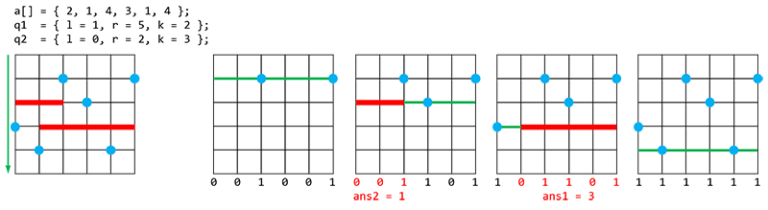
 , offline
 , для концов запросов —
 ). По ординатам построим стандартное дерево отрезков для суммы, в котором будем отмечать появление точек.
 , при обработке конца запроса добавляем к ответу сумму на отрезке
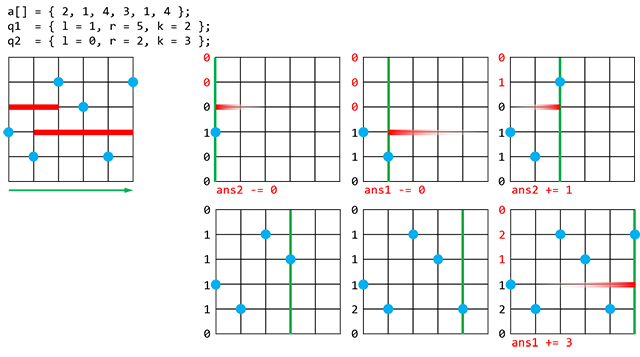
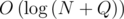 , offline
 до
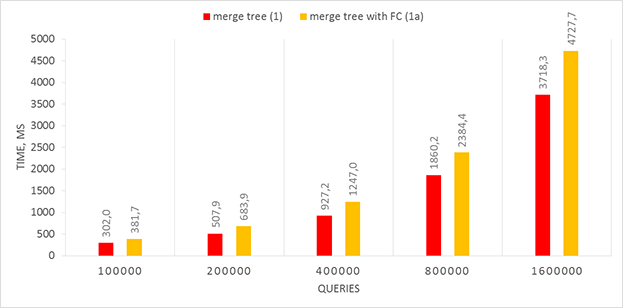
 . Время обработки запроса при этом сократится от
 в версии
 .
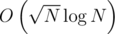 , online
 (получится
 блоков). Отсортируем каждый из блоков.
 . В тех блоках, которые полностью покрываются отрезком запроса, количество чисел, больших
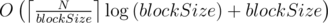 .
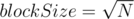 получаем классическую sqrt-декомпозицию, имеющую время обработки запроса
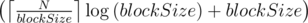 . При
 таким значением будет
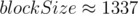 . Тем не менее, фактическое увеличение производительности по сравнению с sqrt-декомпозицией составляет ~5%, что влечёт общую нецелесообразность подобной оптимизации.
 , заполненный случайными числами из диапазона
 . Затем выполним
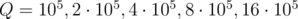 случайных KQUERY-запросов к данному массиву. Для каждого значения
 произведём 10 тестов, в качестве итогового времени возьмём среднее.
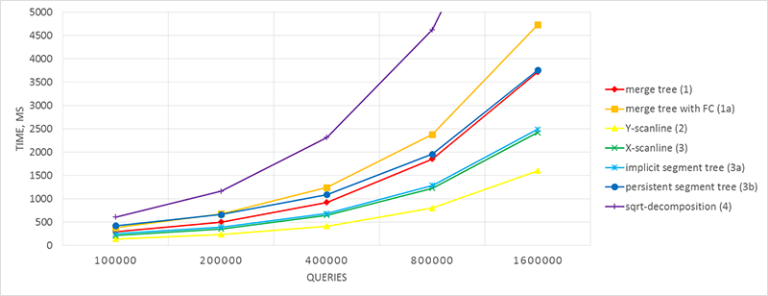
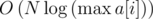 .
 , такой что
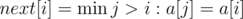 . Другими словами,
 ).
 , что
 . Таким образом, результат запроса DQUERY
 к массиву
 к массиву
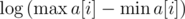 раз выше: из решений KQUERY с асимптотикой
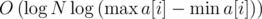
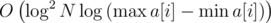 соответственно.


